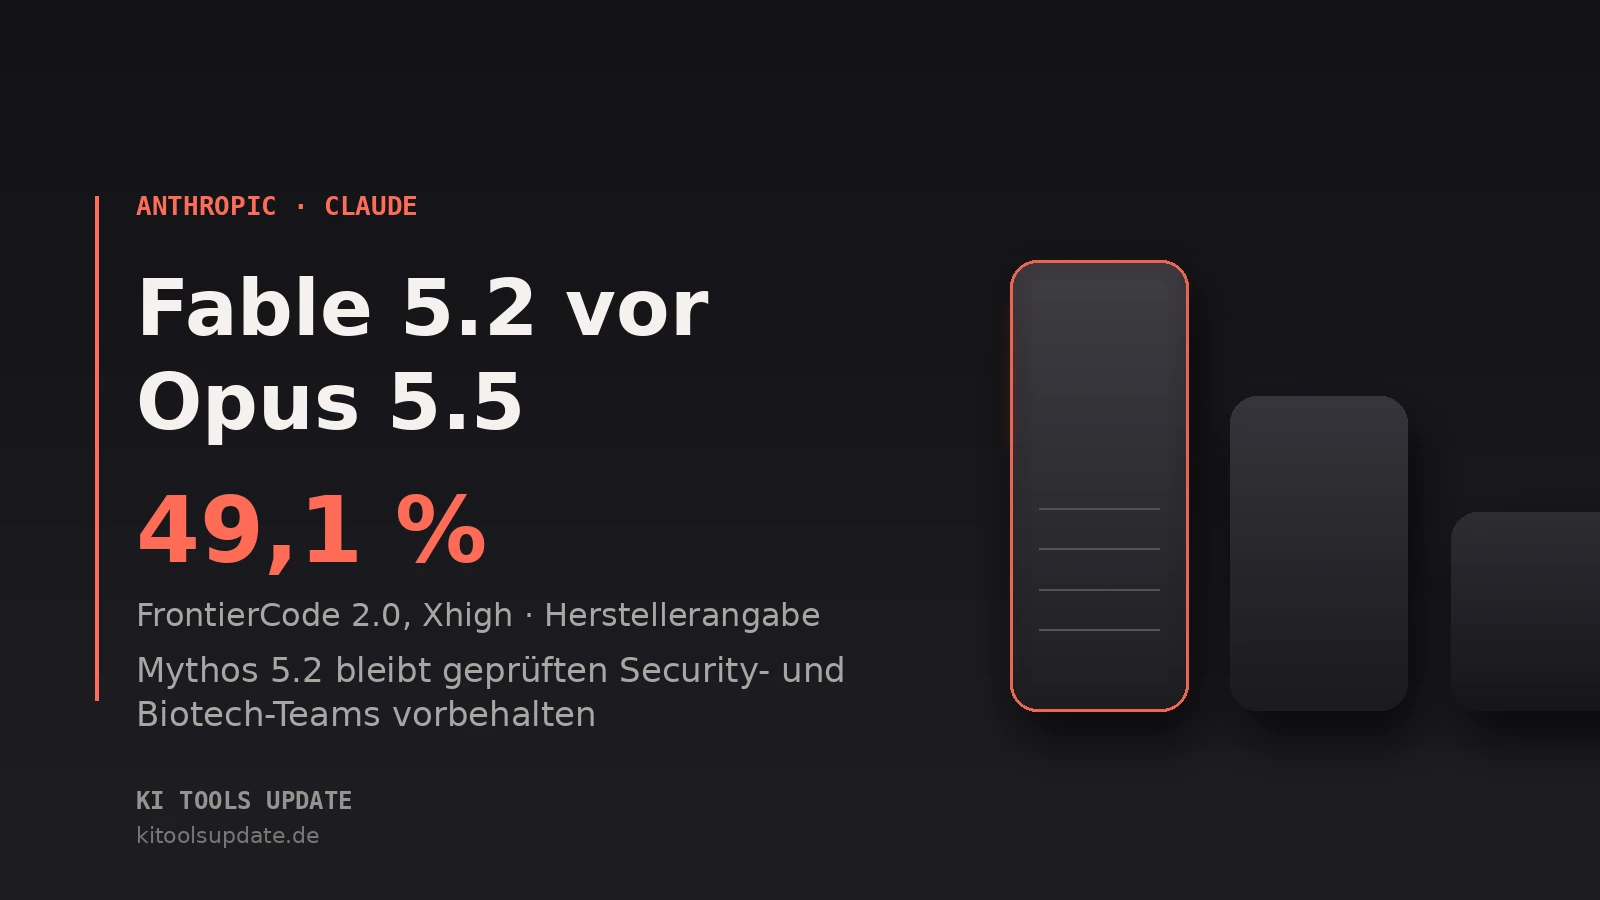
Anthropic hat am 9. November 2026 Claude Fable 5.2 und Claude Mythos 5.2 veröffentlicht. Beide Modelle sind derselbe zugrunde liegende Baukasten: Fable 5.2 ist die abgesicherte Version für alle Nutzer, Mythos 5.2 die Variante ohne die strengen Cyber- und Biologie-Filter, die nur geprüfte Organisationen über Anthropics Verification Programs erhalten. Die eigentliche Neuerung liegt beim Agentic Coding: Im Hersteller-Benchmark FrontierCode 2.0 kommt Fable 5.2 mit maximalem Aufwand auf 49,1 Prozent und liegt damit vor dem bisherigen Alltagsmodell Opus 5.5.
Benchmarks: Wo Fable 5.2 vorne liegt
Anthropic veröffentlicht im Blogbeitrag eine Vergleichstabelle gegen Fable 5.1, Opus 5.5, GPT-6 Astra und Gemini 4 Carbon. Alle Werte sind Herstellerangaben, nicht unabhängig geprüft. Die auffälligsten Abstände:
• FrontierCode 2.0 (Code-Änderungen, die Maintainer mergen würden): 49,1 Prozent für Fable 5.2 bei Xhigh-Effort, vor Opus 5.5 (45,5), GPT-6 Astra (42,8) und Gemini 4 Carbon (41,1). Fable 5.1 kommt auf 32,4 Prozent.
• FrontierSWE v2: 69,9 Prozent, vor GPT-6 Astra (65,5), Opus 5.5 (62,3) und Gemini 4 Carbon (61,2).
• OSWorld 2.1 (Computer Use): 89,3 Prozent gegenüber 87,2 bei Opus 5.5 und 81,5 bei Gemini 4 Carbon.
• Terminal-Bench-Science 0.1: 74,6 Prozent, hier liegt Mythos 5.2 mit 75,3 noch etwas höher; GPT-6 Astra erreicht 68,1, Gemini 4 Carbon 64,8 Prozent.
• Remote Labor Index: 41,3 Prozent bei hohem Aufwand, mehr als das Doppelte von Opus 5.5 (21,3).
• Humanity’s Last Exam mit Tools: 74,2 Prozent gegenüber 67,7 bei Opus 5.5.
Anthropic betont einen Effizienzpunkt: Bei mittlerem Aufwand, dem Standard in Claude-Apps und Claude Code, erreicht Fable 5.2 in FrontierCode 2.0 etwa das Niveau von Opus 5.5 bei maximalem Aufwand – zu rund der Hälfte der Kosten pro Aufgabe. Im selben Datensatz liegt Opus 5.5 in einer Elo-Bewertung mit 1800 Punkten allerdings weiter vorn (Fable 5.2: 1785).
Mythos 5.2: Cybersicherheit als Sonderfall
Die ungefilterte Variante ist laut Anthropic das stärkste Modell für Security-Arbeit. In der internen Auswertung CVE Rediscovery, die über 1.829 veröffentlichte Schwachstellen läuft, findet Mythos 5.2 nach Herstellerangaben 10,2 Prozent mehr Schwachstellen als Opus 5.5 und 14,4 Prozent mehr als Mythos 5.1. Mozilla berichtet im Blogbeitrag, Mythos 5.2 habe die Trefferquote bei der Firefox-Härtung gegenüber Mythos 5.1 ungefähr verdoppelt.
Für die meisten Anwender ist das kein direkt nutzbarer Pfad: Fable 5.2 blockiert Penetrationstests, Exploit-Erzeugung und die meiste Forschungsbiologie. Wer Mythos braucht, muss sich über das Cyber Verification Program oder das Life Sciences Verification Program freischalten lassen. Enterprise-Kunden bekommen Mythos 5.2 indirekt über Claude Security, das Codebasen nach Schwachstellen scannt.
Preise, Tempo und Verfügbarkeit
Fable 5.2 kostet 8 Dollar pro Million Input-Token und 40 Dollar pro Million Output-Token und ist damit günstiger als Fable 5.1. Ein optionaler Fast Mode beschleunigt die Token-Generierung um bis zu 2,5-fach und kostet 16 beziehungsweise 80 Dollar pro Million Token. Die Ausgabegeschwindigkeit liegt laut Anthropic ohnehin bis zu 30 Prozent über Fable 5.1.
Verfügbar ist das Modell ab sofort über Amazon Web Services, Google Cloud und Microsoft Azure sowie als claude-fable-5-2 auf der Claude Platform. Fast Mode läuft auf Claude Code, der Claude Platform, Gemini-Enterprise-Zugängen von Google Cloud und Microsoft Foundry. Abonnenten mit Fable-Zugang erhalten diese Woche zusätzliche Nutzungsresets.
Grenzen und offene Punkte
Drei Einschränkungen sind für die Praxis relevant. Erstens hat Anthropic die Fähigkeiten zur KI-Forschung bewusst begrenzt: Bei Kernel-Optimierung und der Verbesserung von LLM-Architekturen liegen Fable 5.2 und Mythos 5.2 nur auf Opus-5.5-Niveau. Zweitens läuft die Sicherheitsüberwachung über ein Nutzungsfenster statt über einzelne Antworten; Standardkunden haben dabei 30 Tage Aufbewahrung, Zero Data Retention gibt es nur über Enterprise Frontier Safeguards, die sich derzeit in einer privaten Beta mit Kunden wie Bridgewater, Salesforce und Stripe befinden. Drittens bleiben alle Leistungszahlen Herstellerdaten aus internen oder von Anthropic betreuten Evaluierungen.
Anthropic empfiehlt Fable ausdrücklich nicht als Standardmodell. Für die meiste Coding- und Wissensarbeit bleibe Opus 5.5 der Daily Driver; Fable 5.2 ist für aufwendige, offene technische Aufgaben gedacht, etwa als Advisor, den kleinere Modelle bei harten Problemen konsultieren, oder als Orchestrator, der einfache Schritte delegiert. Wer bereits ein Kimi K3.1 Pro oder Gemini 4 Carbon evaluiert, sollte Fable 5.2 in denselben eigenen Testaufbau aufnehmen: Die Herstellerabstände sind groß genug, um sie zu prüfen, aber zu klein, um sie ungeprüft zu übernehmen.
FAQ
Ist Claude Fable 5.2 besser als Opus 5.5?
Bei aufwendigen Coding- und Agenten-Aufgaben liegt Fable 5.2 in den Herstellerbenchmarks vorn, bei einer Elo-Bewertung aus derselben Tabelle und beim Preis-Leistungs-Verhältnis für Alltagsaufgaben bleibt Opus 5.5 die empfohlene Wahl.
Was ist der Unterschied zwischen Fable 5.2 und Mythos 5.2?
Es ist dasselbe Basismodell. Fable hat aktive Cyber- und Biologieschutzfilter und ist für alle verfügbar; Mythos ist ungefiltert und nur für geprüfte Sicherheits- und Biotech-Organisationen zugänglich.
Was kostet Claude Fable 5.2?
8 Dollar pro Million Input-Token und 40 Dollar pro Million Output-Token, im Fast Mode 16 und 80 Dollar.