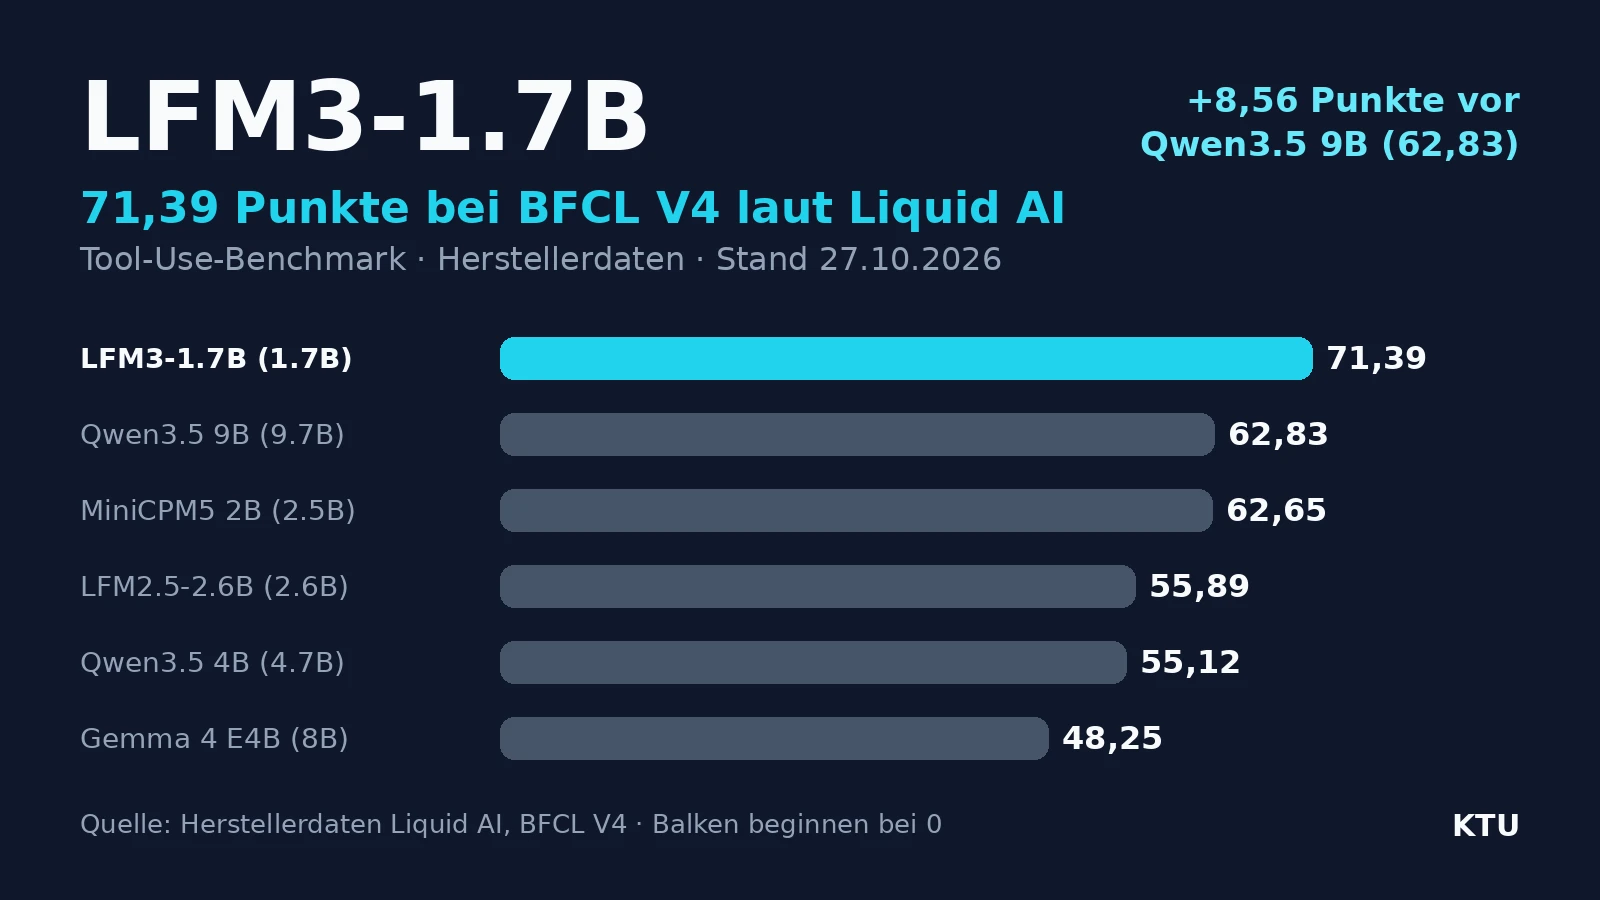
LFM3 ist die neue Modellfamilie von Liquid AI, und die Textbasis LFM3-1.7B zeigt laut Herstellerangaben starke Tool-Use-Werte. Liquid AI veröffentlichte am 27. Oktober 2026 die Familie mit offenen Gewichten auf Hugging Face. Im BFCL V4 erreicht LFM3-1.7B 71,39 Punkte, der stärkste Vergleichswert in der Tabelle ist Qwen3.5 9B mit 62,83. Bei GPQA Diamond liegt das kleine Modell dagegen klar zurück.
Was Liquid AI angekündigt hat
- Familie: LFM3 umfasst sechs Modelle in der 2B-Klasse für Text, Vision, Audio, Omni und Entscheidungen. Alle bauen auf einem gemeinsamen Backbone auf.
- Basis: LFM3-1.7B wurde mit 22 Billionen Tokens vortrainiert. Laut Liquid AI kommt es mit 35 Prozent weniger Parametern auf eine höhere Leistung als der Vorgänger LFM2.5-2.6B.
- Architektur: Eine Mischung aus gegateten Kurzfaltungen, Sliding-Window-Attention und weiteren Operatoren. Liquid AI nennt das Tri-Hybrid-Architektur.
- Edge-Betrieb: Das Textmodell passt laut Liquid AI mit 4-Bit-Quantisierung in rund 1 GB.
- Verfügbarkeit: Base- und nachtrainierte Modelle sind offen auf Hugging Face sowie über die Liquid-AI-API und den Playground verfügbar.
Die Benchmarks laut Herstellerdaten
Liquid AI veröffentlicht eine Vergleichstabelle mit fünf Konkurrenzmodellen. Die Werte stammen vom Hersteller und sind nicht unabhängig geprüft.
- BFCL V4 (Tool-Use): LFM3-1.7B 71,39 · Qwen3.5 9B 62,83 · MiniCPM5 2B 62,65 · LFM2.5-2.6B 55,89 · Qwen3.5 4B 55,12 · Gemma 4 E4B 48,25
- IFEval (Befolgen von Anweisungen): LFM3-1.7B 96,66 · LFM2.5-2.6B 95,39 · Qwen3.5 4B 92,52 · Qwen3.5 9B 92,08 · Gemma 4 E4B 90,02 · MiniCPM5 2B 87,83
- LiveClaw (Agenten-Aufgaben): LFM3-1.7B 45,60 · Qwen3.5 9B 35,77 · MiniCPM5 2B 30,37 · Gemma 4 E4B 20,36 · Qwen3.5 4B 19,94 · LFM2.5-2.6B 14,70
- GPQA Diamond (Fachwissen): Qwen3.5 9B 80,40 · Qwen3.5 4B 75,76 · MiniCPM5 2B 65,15 · LFM3-1.7B 63,37 · LFM2.5-2.6B 57,78 · Gemma 4 E4B 57,88
Der Befund ist eindeutig. LFM3-1.7B gewinnt bei Tool-Use, Agenten-Aufgaben und Befolgen von Anweisungen. Bei Fachwissen verliert es gegen beide Qwen3.5-Modelle deutlich, und zwar um rund 17 Punkte gegenüber Qwen3.5 9B.
Was fehlt
Eine unabhängige Auswertung von Artificial Analysis zu LFM3 habe ich nicht gefunden. Die Zahlen sind deshalb nur Herstellerangaben, bis ein unabhängiger Test vorliegt.
Was das für Anwender bedeutet
- Edge- und Geräte-Projekte mit Funktionsaufrufen und klar umrissenen Aufgaben sind das passende Einsatzfeld. Die Vorgängerfamilie LFM2.5-24B-A2B haben wir bereits am 13. Oktober vorgestellt: LFM2.5-24B-A2B und die Agenten-Benchmarks.
- Wissensintensive Anwendungen brauchen weiterhin ein größeres Modell. Die GPQA-Werte sprechen dagegen, ein 1,7B-Modell dafür zu nehmen.
Vor dem Einsatz lohnt sich ein Test mit den eigenen Aufgaben und Dokumenten, denn Benchmarks des Herstellers zeigen nicht den eigenen Anwendungsfall.
Häufige Fragen
Ist LFM3-1.7B ein Ersatz für große Modelle?
Nein. Bei Fachwissen liegt es klar hinter Qwen3.5 9B.
Wo gibt es das Modell?
Offen auf Hugging Face sowie über die Liquid-AI-API und den Playground.
Quellen
- Liquid AI: Introducing LFM3: Every Modality for Specialized Intelligence, https://liquid.ai/blog/lfm3 (27.10.2026)