Liquid AI hat am 13. Oktober 2026 LFM2.5-24B-A2B vorgestellt, ein Reasoning-Modell mit 24 Milliarden Parametern, von denen pro Token nur 2 Milliarden aktiv sind. Es ist für schnelle, lokale Agenten gebaut, die Werkzeuge aufrufen und mehrstufige Aufgaben abarbeiten. Die Leistungsangaben stammen vom Hersteller; unabhängig geprüft sind sie nicht.
Was das Modell kann
Laut dem Release-Blog denkt das Modell immer, bevor es antwortet. Weil nur 2 Milliarden Parameter pro Token aktiv sind, bleibt jeder Denkschritt vergleichsweise günstig. Das Kontextfenster wächst laut Hersteller von 32.000 auf 131.000 Token. Die Architektur übernimmt Liquid AI von LFM2-24B-A2B: 40 Schichten, 64 Experten pro MoE-Block mit Top-4-Routing.
Liquid AI nennt Tool-Nutzung und das Befolgen von Anweisungen als Stärken. Das Modell soll in mehreren Agenten-Harnesses laufen; dazu gehören laut Blog llama.cpp, MLX, vLLM, SGLang und ONNX.
Die Benchmarks laut Hersteller
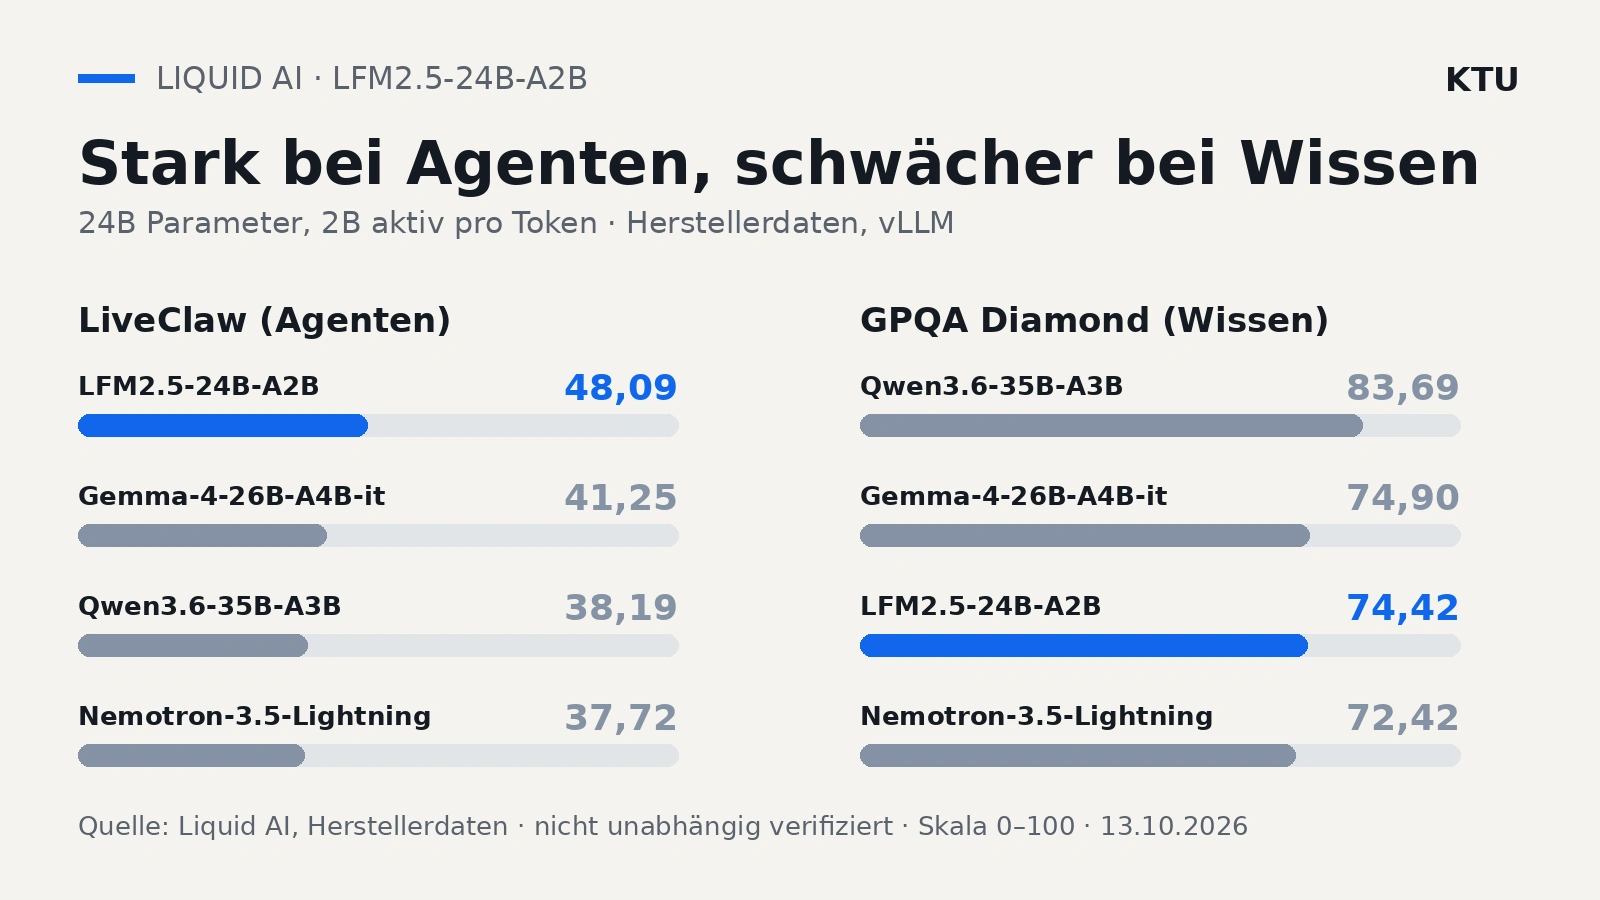
Liquid AI vergleicht das Modell mit Qwen3.6-35B-A3B, Gemma-4-26B-A4B-it und Nemotron-3.5-Lightning. Alle Modelle wurden laut Hersteller mit vLLM und den jeweils empfohlenen Generierungsparametern getestet. Die wichtigsten Werte:
• LiveClaw (Agenten): LFM2.5-24B-A2B 48,09, Gemma-4-26B-A4B-it 41,25, Qwen3.6-35B-A3B 38,19, Nemotron-3.5-Lightning 37,72
• BFCLv4 (Tool-Nutzung): LFM2.5 65,01, Qwen3.6 65,00, Gemma 57,09, Nemotron 53,78
• IFEval (Befolgen von Anweisungen): LFM2.5 96,75, Nemotron 94,19, Qwen3.6 93,06, Gemma 92,00
Die Ergebnisse sind nicht einheitlich. Bei Wissen liegt das Modell zurück: Bei GPQA Diamond erreicht LFM2.5 74,42, Qwen3.6 83,69, Gemma 74,90 und Nemotron 72,42. Bei SWE-Bench Verified (OpenCode) liegt LFM2.5 bei 51,00, Qwen3.6 bei 66,20. Bei PinchBench führt Qwen3.6 mit 89,93 gegen 83,18. Liquid AI selbst empfiehlt deshalb, das Modell bei wissensintensiven Aufgaben mit Retrieval oder Websuche zu kombinieren.
Geschwindigkeit
Laut Hersteller erreicht das Modell 184 Token pro Sekunde auf einem Apple M5 Max und 114 Token pro Sekunde auf einem Ryzen AI Max+ 395. Auf einer einzelnen NVIDIA B300 nennt Liquid AI über 21.000 Ausgabe-Token pro Sekunde bei hoher Parallelität. Diese Werte gelten für die genannten Hardwaresetups und Lastbedingungen; sie sind keine allgemeingültige Aussage über jede Umgebung.
Einordnung
Für lokale Agenten mit Werkzeugaufrufen ist das Profil interessant: Die Tool- und Instruktionswerte sind hoch, die Geschwindigkeit auf Consumer-Hardware ebenso. Wer Wissensfragen oder Programmierung mit großen Modellen als Kernaufgabe hat, sollte dagegen auf Vergleichsmessungen im eigenen Anwendungsfall setzen, bevor er umstellt.
Das Modell ist laut Blog auf Hugging Face verfügbar. Ob und wie es für den eigenen Einsatz lizenzrechtlich passt, muss man auf der Modellkarte prüfen.
Primärquellen:
– Liquid AI, Hugging Face Blog, 13.10.2026: https://huggingface.co/blog/LiquidAI/lfm25-24b-a2b