Alibaba hat am 16. November 2026 Qwen4-Max veröffentlicht. Das Flaggschiff der neuen Qwen4-Generation hat 2,4 Billionen Parameter im Rückgrat, versteht Text und Bilder und arbeitet mit bis zu einer Million Token Kontext. Es ist kein offenes Modell: Gewichte wurden nicht veröffentlicht, kleinere Versionen der Qwen4-Familie sollen später quelloffen folgen.
Primärquellen: Qwen-Blog „Qwen4-Max: Your New Teammate Has Arrived“ vom 16.11.2026 und QwenCloud API-Preise. Unabhängiger Messwert: Artificial Analysis, Intelligence Index v5.0.1.
Was das Modell technisch ist
Qwen4-Max ist ein sparse Mixture-of-Experts: von den 2,4 Billionen Parametern werden pro Token 71 Milliarden aktiviert, dazu kommen 328 Milliarden Parameter für N-Gram-Embeddings. Alibaba beschreibt drei Umbauten gegenüber Qwen3.8-Max:
- GDN plus Qwen Sparse Attention: Gated-DeltaNet-Schichten komprimieren die Historie in Zustände fester Größe, eine leichte Indexierung wählt anschließend nur die relevanten Blöcke aus.
- Gated Residual: vier parallele Residualzweige mit dynamischen Lese- und Schreibgates sollen den Informationsfluss und die Trainingsstabilität verbessern.
- N-Gram-Embedding: kontextabhängige Tabellenzugriffe liefern ab der zweiten Schicht Repräsentationen lokaler Tokenmuster.
Der praktische Effekt ist Sparsamkeit, nicht nur Größe: Laut Hersteller sinkt der Token-Verbrauch gegenüber Qwen3.8-Max auf dem eigenen Work360-Benchmark um rund 24 Prozent (Stufe Xhigh) und 35 Prozent (Stufe High), auf Terminal-Bench 4.0 um 48 bis 49 Prozent.
Benchmarks: klarer Sprung nach vorn, kein Sprung an die Spitze
Alibaba misst Work360 selbst, einen Benchmark aus 26 Berufsdomänen, 182 Unter- und 721 Fachbereichen. Qwen4-Max erreicht dort 52,69 Punkte, Qwen3.8-Max 47,74. Die Secure-Code-Prüfung steigt von 22,0 auf 31,8 Prozent Passrate auf Funktionsebene.
| Messgröße (Herstellerangaben) | Qwen4-Max | Qwen3.8-Max |
|---|---|---|
| Work360, Berufsaufgaben aus 26 Domänen | 52,69 | 47,74 |
| Kosten je Work360-Aufgabe | 1,67 $ | 4,43 $ |
| Token-Verbrauch Terminal-Bench 4.0, Stufe High | rund 49 % weniger | Referenz |
| Passrate Code, Funktion und Sicherheit | 31,8 % | 22,0 % |
Quelle: Qwen-Blog vom 16.11.2026, Herstellerdaten auf Alibabas eigenen Benchmarks.
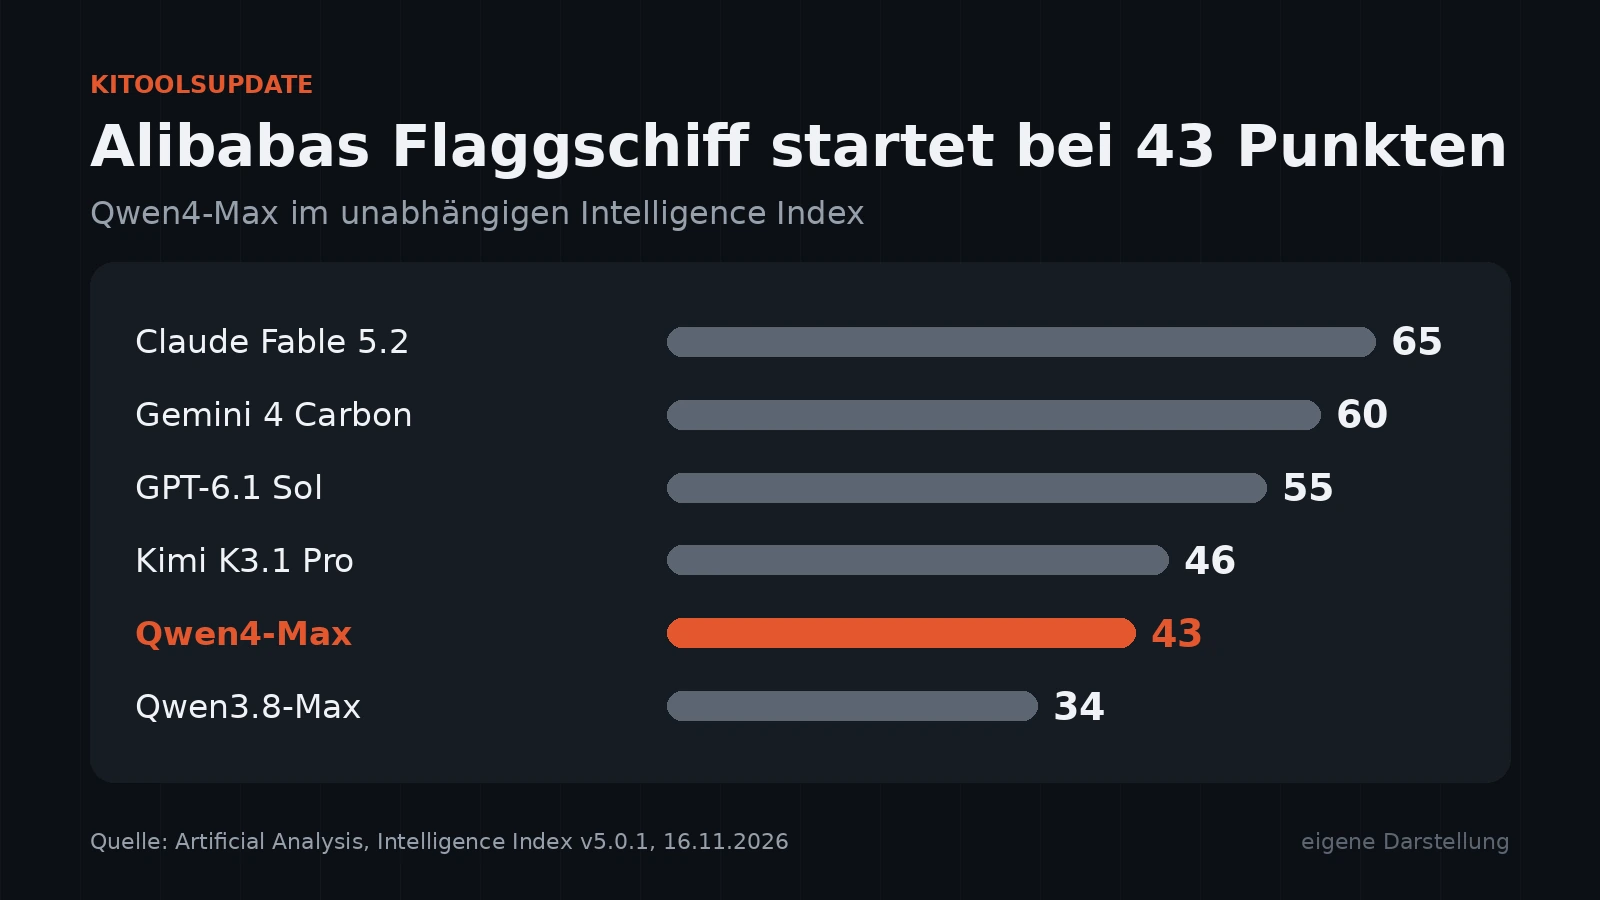
Aussagekräftiger für die Einordnung ist der unabhängige Intelligence Index von Artificial Analysis (v5.0.1, neun Tests, darunter Terminal-Bench 4.0, HLE-Diamond, AA-Briefcase und AutomationBench-AA). Qwen4-Max kommt darin auf 43 Punkte – neun Punkte mehr als Qwen3.8-Max und über dem Median von 41. Gegen die aktuelle Spitze reicht es nicht.
| Modell | Intelligence Index | Kosten je Index-Aufgabe |
|---|---|---|
| Claude Fable 5.2 (max) | 65 | 26,54 $ |
| Gemini 4 Carbon (high) | 60 | 5,48 $ |
| GPT-6.1 Sol (max) | 55 | 1,27 $ |
| Gemini 4 Hydrogen (xhigh) | 54 | 3,16 $ |
| Kimi K3.1 Pro | 46 | – |
| Qwen4-Max | 43 | 3,27 $ |
| Qwen3.8-Max | 34 | – |
Quelle: Artificial Analysis, Intelligence Index v5.0.1, abgerufen am 16.11.2026. Die Denkstufen der Vergleichsmodelle sind in Klammern angegeben und nicht identisch; fehlende Werte sind nicht veröffentlicht.
Damit steht Qwen4-Max hinter Kimi K3.1 Pro (46) – bei Artificial Analysis als offenes Modell geführt – und deutlich hinter Claude Fable 5.2, Gemini 4 Carbon und GPT-6.1 Sol. Alibabas eigene Zahlen und der unabhängige Index widersprechen sich nicht: Der Sprung gegenüber dem Vorgänger ist real, die Lücke zur Spitze auch.
Preis und Effizienz
QwenCloud berechnet je Million Token 1,50 Dollar Eingabe und 4,50 Dollar Ausgabe, für Cache-Treffer 0,075 Dollar. Qwen3.8-Max kostet im Vergleich 2, 6 und 0,25 Dollar. Alibaba rechnet vor, dass die durchschnittlichen Kosten je Work360-Aufgabe von 4,43 auf 1,67 Dollar fallen – 62 Prozent weniger, allerdings auf dem eigenen Benchmark.
Artificial Analysis kommt je Index-Aufgabe auf 3,27 Dollar. Das ist günstiger als Fable 5.2 (26,54 Dollar) und Carbon (5,48 Dollar), aber teurer als GPT-6.1 Sol (1,27 Dollar). Ein Grund ist die Ausführlichkeit: Für den Index erzeugte Qwen4-Max 127 Millionen Token, der Median der Vergleichsmodelle liegt bei 78,6 Millionen.
Was das Modell im Alltag leisten soll
Alibaba zeigt Qwen4-Max in mehreren Kettenläufen, alle als Herstellerdemos ohne unabhängige Prüfung:
- Blender-Szenen mit Modellierung, Material, Licht und Rendering aus einer Beschreibung
- spielbare Prototypen in Unity, Unreal Engine und Godot inklusive Selbsttests über Spiel-Feedback
- Fertigungsplanung: Der Programmieraufwand für ein einzelnes Werkstück sank laut Hersteller von rund 475 auf 24 Minuten
- Investmentrecherche über 90 angebundene MCP-Werkzeuge
- 48-Stunden-Agentenlauf, der mit einem automatisierten Labor einen neuen Kühlmittel-Kandidaten synthetisierte
Dazu veröffentlicht Alibaba ein Plugin für „Live Delivery“: Der Agent liefert Zwischenstände, der Nutzer greift früher ein. Das ist derzeit der praktisch relevanteste Teil für Teams, die lange Agentenläufe einsetzen.
Grenzen
- Keine offenen Gewichte. Es gibt weder Modellkarte noch Download. Wer lokal oder bei einem anderen Anbieter hosten will, ist auf die angekündigten kleineren Qwen4-Modelle angewiesen – ohne Termin.
- Der unabhängige Index bleibt unter der Spitze. 43 Punkte sind ein solides Mittelklasse-Ergebnis, kein Führungsanspruch.
- Sehr gesprächig. 127 Millionen Token für denselben Index bedeuten mehr Ausgabekosten, wenn pro Aufgabe abgerechnet wird.
- Kontext und Ausgabe sind begrenzt. Alibaba dokumentiert eine Million Token Kontext und bis zu 393.216 Token Ausgabe; Artificial Analysis misst 984.000 Token nutzbaren Kontext.
- Nur gehostet. Der Zugang läuft über QwenCloud, den Token Plan sowie QwenWork, Qoder und QwenStudio. Betreiber der Cloud ist Intelligent Cloud Computing mit Sitz in Singapur – für europäische Datenschutzanforderungen ist das ein Prüfpunkt, keine Nebensache.
Für wen sich Qwen4-Max lohnt
Für Teams, die viel Text, Bilder und Dokumente durch ein Modell schicken und dabei auf Preis je Ergebnis achten, ist Qwen4-Max eine plausible Option – vor allem mit Cache und langen Kontexten. Wer die höchste Antwortqualität braucht, bleibt bei Fable 5.2, Gemini 4 Carbon oder GPT-6.1 Sol. Und wer offene Gewichte oder europäische Verarbeitung voraussetzt, ist hier falsch.
Wie schnell sich solche Ranglisten verschieben, zeigt der Blick auf die Gemini-4-Hydrogen-Einordnung: Dort lagen im selben Index andere Modelle vorn, bei einem Achtel der Kosten je Aufgabe.
Häufige Fragen
Ist Qwen4-Max ein offenes Modell?
Nein. Alibaba hat nur die API und den Token Plan geöffnet. Kleinere Modelle der Qwen4-Familie sollen laut Blog quelloffen erscheinen, ein Datum nennt das Unternehmen nicht.
Wie gut ist Qwen4-Max im Vergleich zu GPT-6.1 Sol?
Im unabhängigen Intelligence Index von Artificial Analysis erreicht Qwen4-Max 43 Punkte, GPT-6.1 Sol 55. Bei den Kosten je Index-Aufgabe liegt Sol mit 1,27 Dollar unter Qwen4-Max mit 3,27 Dollar.
Was kostet Qwen4-Max?
1,50 Dollar je Million Eingabe-Token, 4,50 Dollar je Million Ausgabe-Token und 0,075 Dollar für zwischengespeicherte Eingabe. Der Token Plan bündelt den Zugang als Abo.