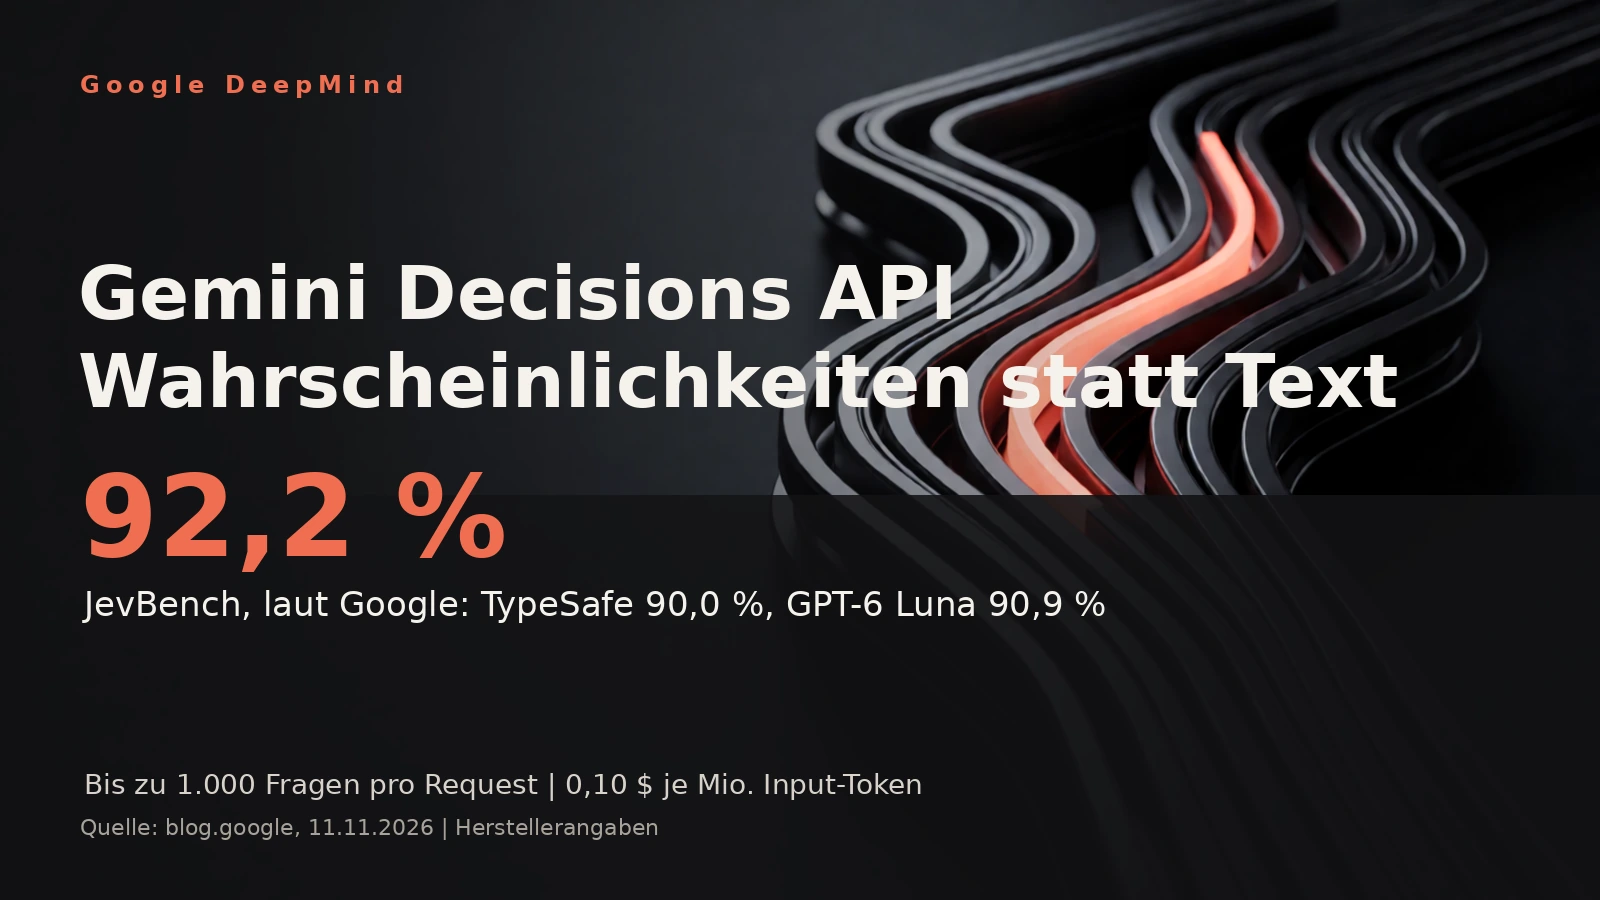
Google hat am 11. November 2026 die Gemini Decisions API vorgestellt. Die Schnittstelle schreibt keine Antworttexte mehr, sondern bewertet vorgegebene Optionen und gibt Wahrscheinlichkeiten zurück. Das Modell dahinter heißt Gemini Decision 1 und ist über die Gemini API sowie Google AI Studio erreichbar.
Primärquelle: Gemini Decisions API: Fast, calibrated multimodal decisions, Google, 11.11.2026
Was die API tatsächlich tut
Entwickler übergeben eine gemeinsame Eingabe aus Text, Bild, Audio, Video oder PDF mit bis zu 256.000 Token und dazu bis zu 1.000 unabhängige Fragen. Jede Frage gehört zu einem von drei Typen:
- Ja/Nein: Die API schätzt die Wahrscheinlichkeit, dass eine Bedingung zutrifft, optional mit beschriebenen Kriterien für wahr und falsch.
- Auswahl: Sie entscheidet zwischen 2 und 255 Optionen und liefert die Gewinner-Option samt normalisierter Wahrscheinlichkeiten für alle Kandidaten.
- Bewertung: Sie ordnet eine Eingabe auf einer geordneten Skala ein und gibt einen gewichteten Wert plus Wahrscheinlichkeit je Stufe zurück.
Jede Antwort enthält einen Konfidenzwert zwischen 0 und 1. Damit lässt sich im Code festlegen, wann ein Fall an einen Menschen oder an ein größeres Modell weitergereicht wird. Typische Einsatzfelder sind Werkzeugauswahl in Agenten, Policy-Prüfungen, Modell-Routing und die Bewertung von abgerufenem Kontext.
Gemini Decision 1 verzichtet auf tokenweise Textgenerierung. Das Modell bewertet die Kandidaten in einem einzigen Vorwärtsdurchlauf, deshalb fallen keine Output-Token an. Google nennt 50 bis 100 Millisekunden reine Modellrechenzeit und 150 bis 250 Millisekunden Ende-zu-Ende bei Kontexten bis 16.000 Token; die Latenz bleibt laut Hersteller von 1 bis 100 Fragen pro Anfrage nahezu konstant.
Die Vergleichswerte laut Google
Google vergleicht Gemini Decision 1 in einer eigenen Tabelle mit TypeSafe Jev 1.14, GPT-6 Luna über die OpenAI Decisions API und Gemini 3.5 Flash-Lite über die Interactions API. Alle Werte sind Herstellerangaben, Top-1-Genauigkeit in Prozent.
| Benchmark | Gemini Decision 1 | TypeSafe Jev 1.14 | GPT-6 Luna | Gemini 3.5 Flash-Lite |
|---|---|---|---|---|
| JevBench | 92,2 % | 90,0 % | 90,9 % | 86,6 % |
| Amazon ESCI | 58,7 % | 56,7 % | 54,7 % | 47,2 % |
| New Yorker Caption | 79,7 % | 72,0 % | 68,4 % | 73,7 % |
| Mind2Web Multimodal | 86,2 % | 86,8 % | 81,8 % | 78,0 % |
| PubMedQA | 79,8 % | 78,2 % | 74,4 % | 77,6 % |
| Global-MMLU-Lite | 86,0 % | 85,0 % | 79,6 % | 78,8 % |
| When2Call | 79,9 % | 82,0 % | 70,4 % | 60,9 % |
| Video-MME | 69,1 % | – | – | 63,3 % |
Werte: Google, 11.11.2026. Gemini Decision 1 liegt in sechs der acht Zeilen vorn. Zwei Ausreißer bleiben: Bei Mind2Web Multimodal gewinnt TypeSafe Jev 1.14 mit 86,8 gegen 86,2 Prozent, bei When2Call mit 82,0 gegen 79,9 Prozent. Auf JevBench als der breitesten Routing-Prüfung liegt der Vorsprung bei 1,3 Punkten vor GPT-6 Luna und 2,2 Punkten vor TypeSafe.
Den zweiten Teil der Geschichte bildet die Kalibrierung. Google gibt für Gemini Decision 1 einen Top-1-ECE von 0,0250 an, TypeSafe kommt auf 0,0494, GPT-6 Luna auf 0,0721 und Gemini 3.5 Flash-Lite auf 0,2104. Ein niedrigerer Wert heißt: Die ausgegebene Wahrscheinlichkeit passt besser zur tatsächlichen Trefferquote. Der Abstand zu Flash-Lite beträgt Faktor 8,4, zu TypeSafe Faktor 2,0. Wer Schwellenwerte für automatische Entscheidungen setzt, kann sich darauf aber nur so weit verlassen, wie die Werte für die eigene Domäne gelten: Gemessen wurde über sieben gemeinsame Evaluationssets, nicht über eine fachliche Prüfung.
Preis, Grenzen und offene Punkte
Der Preis liegt bei 0,10 US-Dollar pro Million Input-Token und 0 Output-Token. Die gemeinsame Eingabe wird pro Anfrage einmal abgerechnet, unabhängig davon, wie viele Fragen dagegen laufen. Google beziffert die Kosten über die getesteten Benchmarks mit 0,88 Dollar gegenüber 4,14 Dollar für Gemini 3.5 Flash-Lite und erklärt das Modell damit als rund fünffach günstiger. In derselben Tabelle ist TypeSafe Jev 1.14 mit 0,68 Dollar allerdings billiger als Gemini Decision 1.
Die wichtigste Einschränkung ist funktional: Die API beantwortet ausschließlich geschlossene Fragen. Sie kann keine Zusammenfassung, keine Erklärung und keinen Fließtext liefern; wer das braucht, bleibt bei einem generativen Modell. Dazu kommen Grenzen, die Google selbst nennt: Die Latenzangaben gelten für Kontexte bis 16.000 Token, abgelehnte Anfragen und Safety-Blocks werden in den Benchmarks als falsch gewertet, und die Kalibrierung ist ein Durchschnitt über die Testreihe. Unabhängige Messungen für dieses Modell lagen zum Redaktionsschluss nicht vor.
Dritter Anbieter mit demselben Muster
Google ist nicht der erste Anbieter mit einer Entscheidungs-API. OpenAI hat seine Decisions API am 6. Oktober 2026 als Beta gestartet, Microsoft folgte am 9. Oktober mit Decision-1. Der Unterschied liegt im Zuschnitt: OpenAI und Microsoft liefern Klassifikation als eigenen Dienst, Google verbindet sie mit multimodaler Eingabe und einem Preismodell ohne Output-Token.
Für Agenten ist das der praktisch relevante Teil. Werkzeugauswahl, Sicherheitsfilter und Kontextbewertung sind Entscheidungen mit kleiner Antwortmenge, für die generative Aufrufe teuer und langsam sind. Google zeigt das an eigenen Produkten: Gemini Notebook nutzt die API als Router und senkt die Latenz für Alltagsfragen laut Hersteller um bis zu 40 Prozent, Stitch erzeugt damit Wireframes, CC wählt Emoji-Reaktionen aus über 200 Optionen, und die Suche prüft damit MCP-Werkzeuge auf adversariales Verhalten.
Wie man startet
Ein API-Schlüssel aus Google AI Studio genügt für den Einstieg, im No-Cost-Tier lässt sich prototypisieren. Die Dokumentation enthält Beispiele für Python, JavaScript und REST. Integrationen kündigt Google für OpenRouter, LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit und OpenCode an, Unterstützung in Gemini in Google Cloud soll folgen. Wer heute produktiv baut, nimmt den direkten SDK-Weg.
Häufige Fragen
Kann Gemini Decision 1 Freitext schreiben?
Nein. Das Modell bewertet ausschließlich vorgegebene Optionen und Rubriken. Für Antworttexte ist ein generatives Gemini-Modell nötig.
Was kostet die API?
0,10 US-Dollar pro Million Input-Token, Output-Token werden nicht berechnet. Die gemeinsame Eingabe zählt einmal pro Anfrage, jede Frage nur mit ihrer eigenen Anweisung.
Ist die API produktionsreif?
Seit dem 11. November 2026 ist sie über die Gemini API und AI Studio mit Preisen und dokumentierten Grenzen verfügbar. Unabhängige Vergleichswerte fehlen noch, die Leistungsangaben stammen von Google.