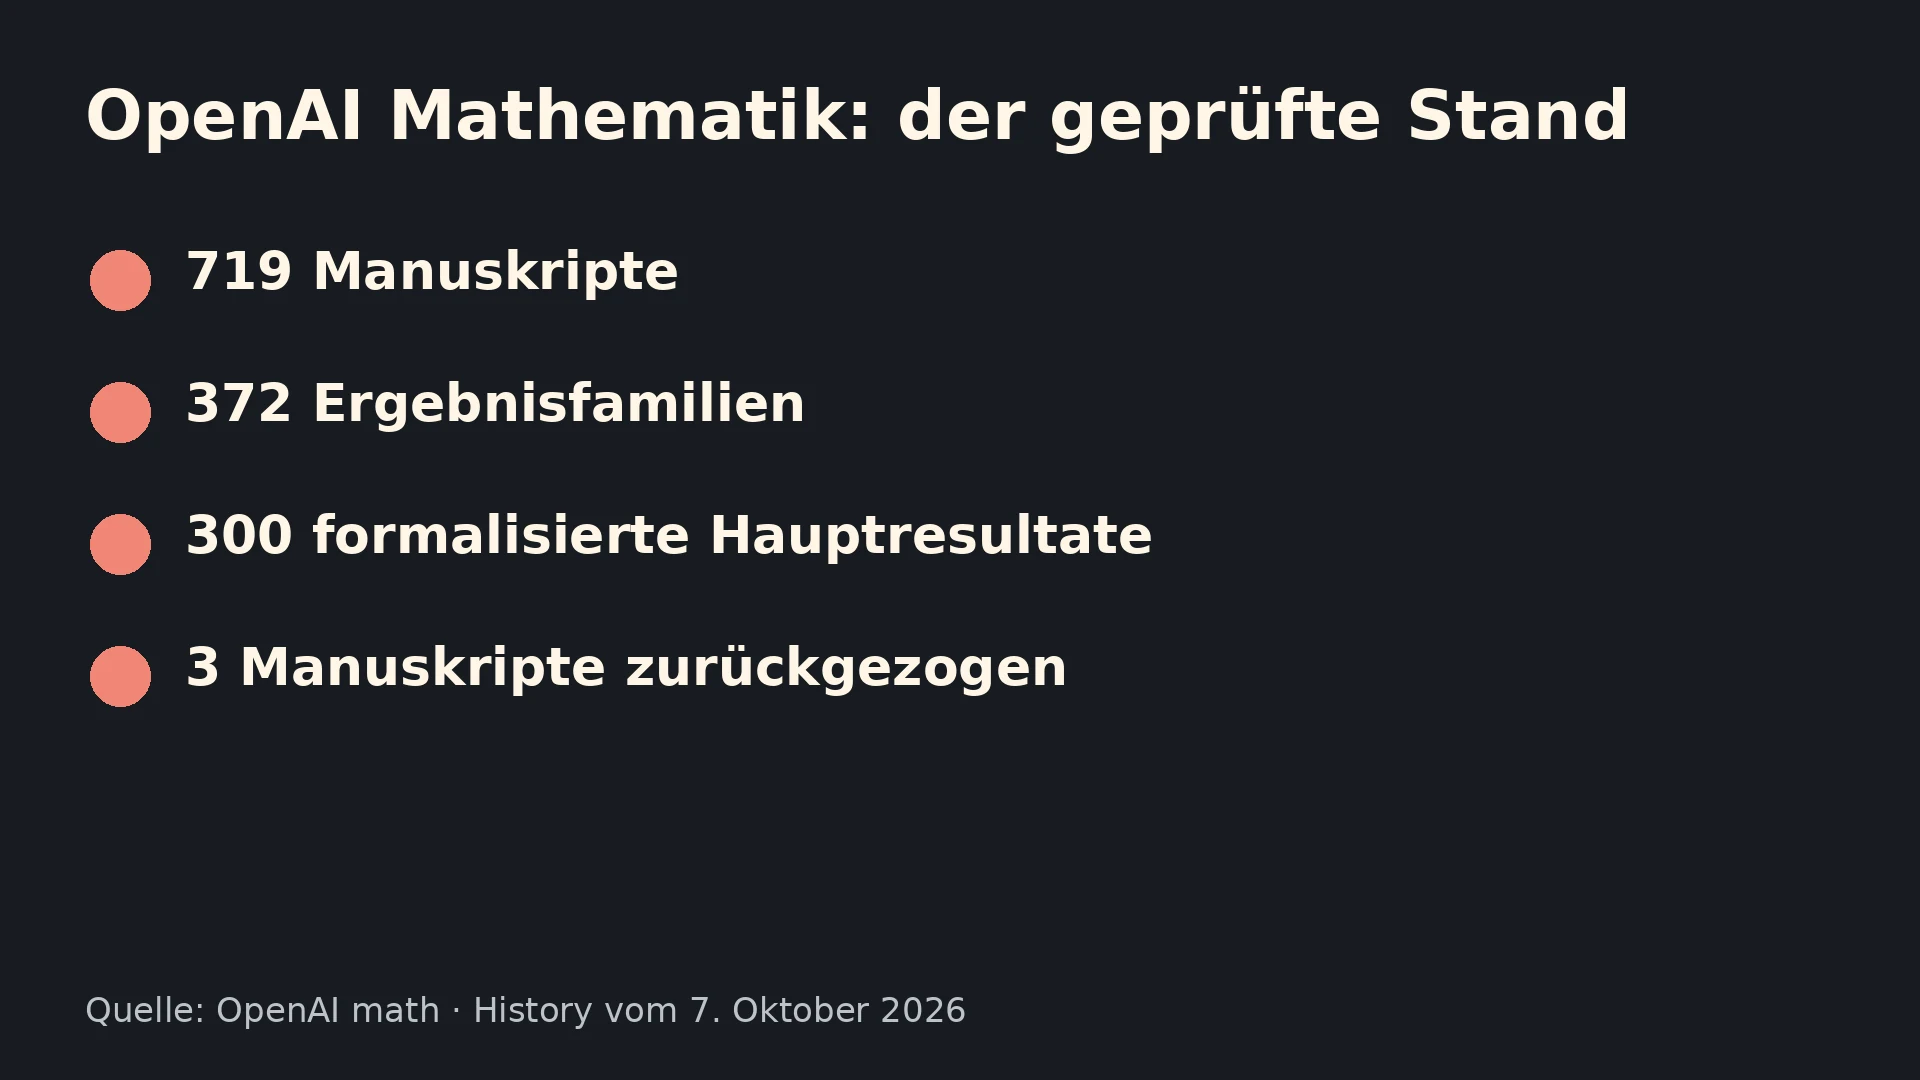
OpenAI veröffentlicht in seinem Mathematik-Repository eine umfangreiche Sammlung von Forschungsresultaten eines internen KI-Modells. Stand 12. Oktober 2026 enthält der Katalog 719 Manuskripte in 372 Ergebnisfamilien. Für rund 42 Prozent der Hauptresultate liegen laut Repository formale Beweise vor. Die Sammlung ist ein bedeutender Beitrag zur KI-gestützten Mathematik – aber nicht gleichbedeutend mit 719 unabhängig bestätigten neuen Durchbrüchen.
Was die Zahlen tatsächlich zählen
Eine Ergebnisfamilie bündelt zusammengehörende Arbeiten: ein Hauptresultat, ergänzende Argumente, Folgerungen oder alternative Beweise. Mehrere Manuskripte können deshalb auf denselben Kernbeitrag zurückgehen. Die Zahl der PDFs ist keine belastbare Zahl voneinander unabhängiger Entdeckungen.
Laut OpenAI entstanden die meisten Resultate mit einem noch unveröffentlichten internen Modell. Im Verlauf der Evaluation wurden ungefähr 4.000 Probleme gestellt. Der aktuelle Katalog umfasst die daraus ausgewählten, als ausreichend bedeutend eingeschätzten Ergebnisfamilien und Manuskripte. Daraus folgt weder, dass alle gestellten Probleme gelöst wurden, noch dass Nutzer die Ergebnisse bereits mit einem öffentlich verfügbaren ChatGPT-Modell reproduzieren können.
Formale Beweise machen die Veröffentlichung überprüfbar
Das Repository stellt neben PDF-Manuskripten Quelltexte und Lean-Formalisierungen bereit. Ein formaler Beweis übersetzt mathematische Aussagen und Beweisschritte in eine Form, deren regelgerechte Ableitung ein Beweisprüfer kontrollieren kann.
Das ist stärkere Evidenz als ein überzeugend formulierter Text allein. Trotzdem muss der Umfang stimmen: Welche Aussage wurde formalisiert, welche Voraussetzungen wurden verwendet und entspricht sie tatsächlich dem Hauptsatz des zugehörigen Papers? Formale Prüfbarkeit ersetzt nicht diese Zuordnung.
Die Änderungshistorie vom 7. Oktober nennt 300 formalisierte Hauptresultate bei insgesamt 719 Manuskripten, also ungefähr 42 Prozent. Eine zusätzliche Formalisierung eines Hilfsarguments ist nicht automatisch ein weiterer vollständig bestätigter Hauptsatz. Für nicht formalisierte Resultate weist OpenAI ausdrücklich auf mögliche Probleme hin.
Bereits drei Manuskripte zurückgezogen
Die Veröffentlichung enthält nicht nur Erfolgsmeldungen, sondern auch dokumentierte Korrekturen. Laut Änderungshistorie machte ein Vorzeichenfehler ein Argument in „Algebraicity of Weil classes on split abelian eightfolds“ ungültig. Zwei davon abhängige Manuskripte wurden ebenfalls zurückgezogen: eines zu Kuga–Satake-Korrespondenzen für K3-Flächen und eines zur rationalen Hodge-Vermutung für Produkte von K3-Flächen.
OpenAI dokumentiert außerdem Reparaturen an 14 weiteren Manuskripten und entsprechende Aktualisierungen von Verweisen in anderen Arbeiten. Das ist entscheidend für die Einordnung: Die Sammlung entwickelt sich weiter. Wer ein Resultat verwenden oder zitieren möchte, muss die aktuelle Fassung und ihre Abhängigkeiten prüfen, nicht nur die ursprüngliche Ankündigung.
Riemann: ein konkretes Teilresultat, nicht die ganze Vermutung
Ein prominentes Beispiel ist die Quasi-Riemann-Formalisierung. Sie beschreibt eine nullstellenfreie Halbebene mit Realteil größer als 7/8 für die Riemannsche Zetafunktion und weitere L-Funktionen. Die Dokumentation begrenzt genau, welche Aussagen enthalten sind; spätere Anwendungen des Papers gehören nicht zur Formalisierung.
Das ist nicht der vollständige Beweis der Riemannschen Vermutung. Der Unterschied lässt sich nicht mit einer verkürzten Schlagzeile übergehen. Vergleichbar müssen andere große Problemnamen immer zusammen mit dem tatsächlich beanspruchten Spezialfall und seinen Voraussetzungen gelesen werden.
Wie sich einzelne Ergebnisse nachprüfen lassen
Für einen sinnvollen Einstieg verweist OpenAI auf die Übersicht der Ergebnisfamilien und die Zuordnung einzelner Manuskripte. Anschließend helfen die jeweilige Paper-Fassung, Formalisierungseinträge und Umfangsnotizen bei der Frage, was genau geprüft werden kann.
Die Comparator-Dokumentation trennt Hauptaussagen ausdrücklich von mehreren Konfigurationen für unterstützende Resultate. Ein erfolgreicher Vergleich eines Hilfsresultats wäre daher kein Nachweis für sämtliche Schlussfolgerungen des zugehörigen Papers. KTU hat die veröffentlichten Dokumente geprüft, aber diese formalen Builds nicht selbst ausgeführt.
Die eigentliche Nachricht bleibt stark: OpenAI legt eine große, teilweise formal überprüfbare mathematische Forschungssammlung offen und dokumentiert auch Fehler. Ihr Wert liegt in konkreten Resultaten, nachvollziehbaren Beweisartefakten und überprüfbaren Geltungsbereichen – nicht in der Gleichsetzung jeder Manuskriptdatei mit einem bereits abschließend bestätigten Durchbruch.