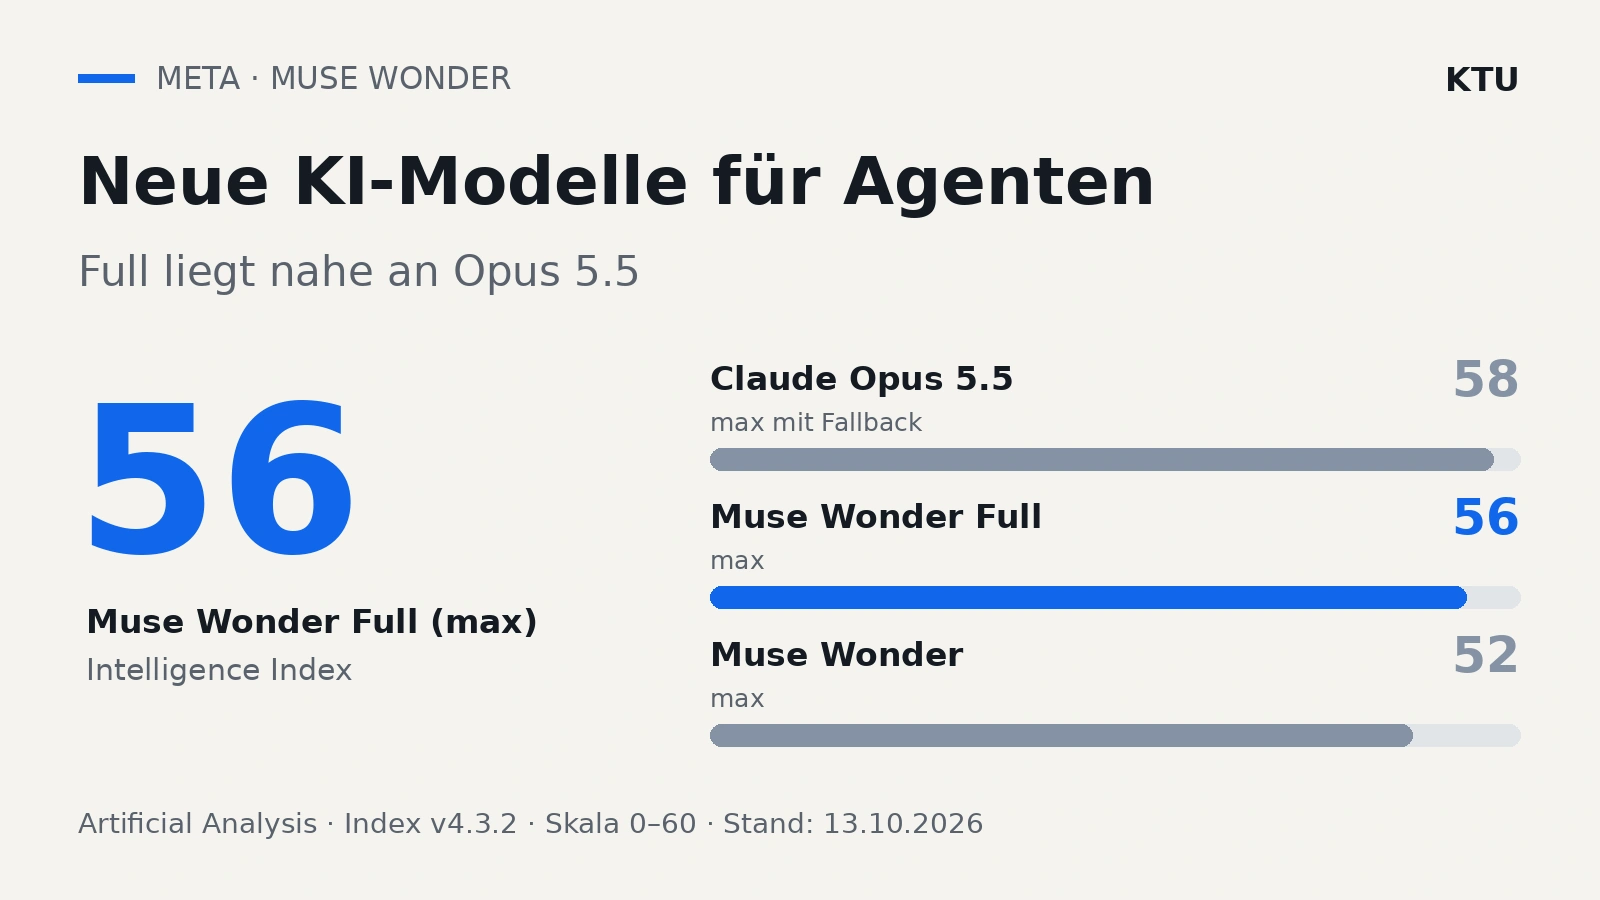
Meta hat am 12. Oktober 2026 Muse Wonder und Muse Wonder Full vorgestellt. Die KI-Modelle richten sich an längere Programmieraufgaben und Agenten, die mehrere Arbeitsschritte ausführen. Im unabhängigen Intelligence Index von Artificial Analysis erreicht die Full-Variante in der Einstellung „max“ 56 Punkte. Damit liegt sie nahe an Claude Opus 5.5, das mit „max mit Fallback“ auf 58 Punkte kommt – aber nicht darüber.
Die eigentliche Neuerung ist Metas nächster Modellschritt für Arbeit mit Werkzeugen, längerem Kontext und wiederholten Tests. Muse Wonder ist laut Metas Ankündigung über die Meta Model API und Muse Code verfügbar. Muse Wonder Full startet für Abonnenten von Muse Code. Die beiden Zugangswege sind nicht gleichzusetzen: Die Veröffentlichung bestätigt keine allgemeine API-Verfügbarkeit der Full-Variante.
Wie leistungsfähig ist Muse Wonder?
Für die Leistungsposition lohnt sich zuerst der Blick auf eine unabhängige Messung. Artificial Analysis führt Muse Wonder Full mit 56 Punkten im Intelligence Index v4.3.2. Muse Wonder erreicht 52 Punkte. Beide Werte beziehen sich auf die Reasoning-Einstellung „max“.
Die dort angezeigten Vergleichswerte helfen bei der Einordnung:
- Claude Opus 5.5, max mit Fallback: 58 Punkte.
- Muse Wonder Full, max: 56 Punkte.
- Claude Fable 5.1, max mit Fallback: 53 Punkte.
- GPT-6 Astra, max: 53 Punkte.
- Muse Wonder, max: 52 Punkte.
Das ist ein starker Messwert für Full, kein Beleg für die beste KI in jeder Disziplin. Der Index bündelt zehn unterschiedliche Evaluationen. Eine kleine Punktedifferenz ersetzt weder einen Test der eigenen Aufgaben noch die Betrachtung des verwendeten Denkaufwands.
Lange Coding-Aufgaben: Modell und Agent gehören zusammen
Bei SWE-Marathon geht es nicht um einen kurzen Code-Vorschlag, sondern um umfangreiche Softwareprojekte. Aufgaben werden über ausführbare Tests bewertet. Der aktuelle SWE-Marathon-Leaderboard von Abundant AI weist in Version 1.1 folgende Erfolgsquoten aus:
- Muse Wonder Full, max, mit Muse Code: 53,1 Prozent.
- Muse Wonder, max, mit Muse Code: 52,5 Prozent.
- Claude Opus 5.5, max, mit Claude Code: 46,3 Prozent.
Die Rangliste berichtet pass@1 auf Basis wiederholter Versuche. Eine Aufgabe zählt nur dann als vollständig gelöst, wenn alle Prüftests bestanden werden. Entscheidend ist die Kombination aus Modell und Coding-Agent: Die Werte stammen nicht aus einem kontrollierten Vergleich mit identischer Agenten-Umgebung.
Metas Veröffentlichung nennt für Full außerdem 57,5 Prozent bei SWE-Marathon. Die Modellkarte kennzeichnet diesen Wert ausdrücklich als „xhigh“. Er ist deshalb nicht derselbe Messpunkt wie die aktuell angezeigten 53,1 Prozent für „max“. Für die obige Einordnung verwenden wir die aktuelle unabhängige Rangliste und vermischen die Einstellungen nicht.
Was bedeuten Active Memory und Active Focus?
Mit Active Memory beschreibt Meta das Wiederfinden relevanter Informationen aus früheren Gesprächen. Ein Agent soll etwa bereits genannte Anforderungen berücksichtigen, statt bei jedem neuen Arbeitsschritt den Zusammenhang zu verlieren.
Active Focus steht für das Weiterarbeiten an anspruchsvollen Zielen: alternative Ansätze ausprobieren, mit Hindernissen umgehen und neue Informationen einbeziehen. Laut Meta sollen die Modelle bei Bedarf Rückfragen stellen und vor wichtigen Handlungen nachfragen.
Ein konkreter Anwendungsfall ist eine Änderung in einem größeren Repository: Anforderungen verfolgen, mehrere Dateien bearbeiten, Tests ausführen und Fehler anschließend korrigieren. Das beschreibt den vorgesehenen Arbeitsablauf – nicht einen von uns durchgeführten Praxistest.
Für das Erinnern von Kontext nennt Meta im internen MemoryBench 85,5 Prozent für Muse Wonder Full „max“, gegenüber 81,5 Prozent für Claude Opus 5.5 „max“. Laut Modellkarte prüft dieser Benchmark wichtige Informationen in längeren Gesprächen mit Ablenkungen und nachträglichen Änderungen. Diese Herstellerdaten sind getrennt vom unabhängig ermittelten Intelligence Index zu lesen.
Zugang und Grenzen
Muse Wonder lässt sich laut Veröffentlichung über die Meta Model API und den Coding-Agenten Muse Code nutzen. Full ist zum Start über Muse Code für Abonnenten erhältlich. Die spätere Integration in die Muse-Anwendung kündigt Meta erst an; sie ist nicht mit dem belegten Startzugang gleichzusetzen.
Die wichtigste Grenze für visuelle Projekte benennt Meta selbst: Visuelles und räumliches Denken, insbesondere 3D-Aufgaben, bleiben bekannte Schwächen. Auch mehrstufige Schlussfolgerungen können fehlschlagen. Die Modellkarte weist außerdem darauf hin, dass Werkzeuge, Prompts, Serving-Konfiguration und Agenten-Umgebung das Ergebnis beeinflussen.
Für Entwickler ist Muse Wonder damit ein neuer Kandidat für längere Coding- und Agentenabläufe. Full liefert starke unabhängige Leistungsdaten. Wer auf dieser Basis zwischen Modellen entscheidet, sollte aber erfolgreiche Softwaretests, Gesprächsgedächtnis und räumliche Generierung nicht zu einem einzigen Qualitätsversprechen zusammenziehen.