Mistral Large 4 ist seit dem 6. Oktober 2026 als öffentliche API-Preview in Mistral Studio verfügbar. Das multimodale Mixture-of-Experts-Modell verbindet Bildverständnis, Coding und Werkzeugnutzung. Die angekündigten offenen Gewichte sind jedoch noch kein Download: Mistral nennt in seiner Release-Ankündigung Ende Oktober als Veröffentlichungstermin. Stand dieses Artikels ist der 12. Oktober 2026.
Eine Billion Parameter, aber kein lokales 52B-Modell
Die Ankündigung beschreibt rund eine Billion Gesamtparameter und 52 Milliarden aktive Parameter. Die technische Modelldokumentation präzisiert den Umfang auf 1,05 Billionen und nennt zusätzlich einen Vision-Encoder mit 1,6 Milliarden Parametern sowie ein Kontextfenster von einer Million Tokens.
Aktive Parameter beschreiben den jeweils genutzten Teil des Expertenmodells, nicht den vollständigen Speicherbedarf. Aus der Zahl 52B lässt sich deshalb keine Hardwareempfehlung für eine lokale Installation ableiten. Ohne veröffentlichte Gewichtsdateien sind Downloadumfang, konkrete Gewichtelizenz und unterstützte Self-Hosting-Runtimes noch nicht abschließend anhand der Artefakte prüfbar.
Für den aktuellen API-Einsatz dokumentiert Mistral strukturierte Ausgaben, Function Calling, Dokumentenfragen und Agentenfunktionen. Der multimodale Schwerpunkt liegt unter anderem auf Dokumenten, Diagrammen und visueller Lokalisierung. Daraus folgt nicht, dass jede gezeigte Agentendemo allein durch einen einzelnen Modellaufruf reproduzierbar wäre: Werkzeugzugang und Ausführungsumgebung gehören zum Gesamtsystem.
Coding: konkurrenzfähig, aber nicht durchgängig vorn
Mistral berichtet 61,7 Prozent auf DeepSWE 1.1 und 28,3 Prozent auf Terminal-Bench 4. Die zugehörigen Grafiken runden die Modellwerte; ihre Vergleichsbalken zeigen folgende Ergebnisse:
- DeepSWE 1.1: Mistral Large 4 Preview rund 62 Prozent, DeepSeek V4 Pro 0813 mit Codex 57, Qwen3.8 Max mit Claude Code 51 und GLM-5.3 mit OpenCode 61. Kimi K3 mit Kimi Code CLI liegt bei 68.
- Terminal-Bench 4: Mistral rund 28 Prozent, DeepSeek V4 Pro 0813 10, Qwen3.8 Max 17 und Kimi K3 21. GLM-5.3 erreicht 40.
Die unterschiedlichen Coding-Agenten im DeepSWE-Vergleich sind eine wesentliche Einschränkung: Gemessen werden nicht isolierte Modellgewichte unter einer nachgewiesen identischen Werkzeugkonfiguration. Außerdem vermerkt Mistral, dass Artificial Analysis diese Zahlen vor dem öffentlichen Start des Test-Harness privat erhoben hat. Die geplante Aufnahme in einen öffentlichen Index ist nicht mit einem bereits öffentlich reproduzierten Test gleichzusetzen.
AutomationBench zeigt den praktischen Schwerpunkt
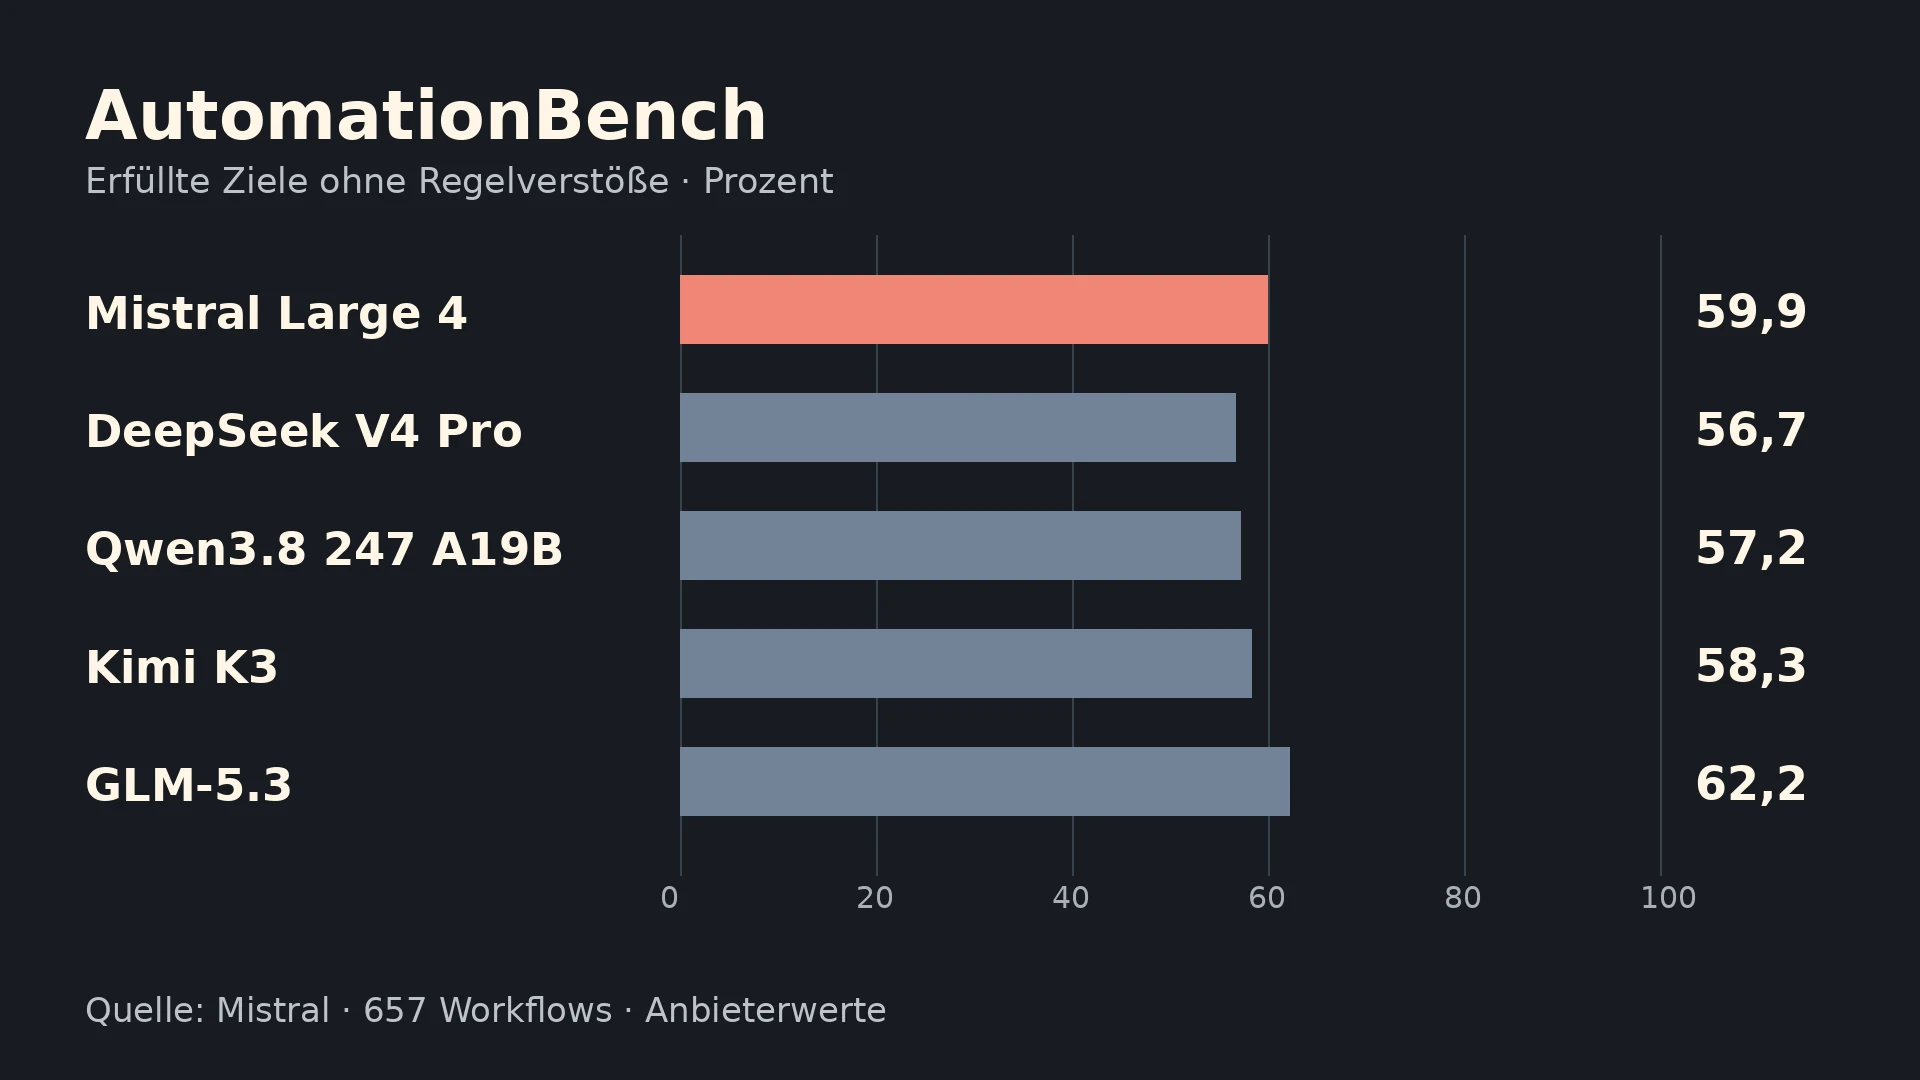
Auf AutomationBench erreicht Mistral Large 4 laut Anbieter 59,9 Prozent. Der Test umfasst 657 Arbeitsabläufe über Anwendungen wie Gmail, Google Sheets und Slack. Die Grafik zählt erfüllte Ziele ohne Regelverstöße: DeepSeek V4 Pro 0813 kommt auf 56,7 Prozent, Qwen3.8 247 A19B auf 57,2 und Kimi K3 auf 58,3. GLM-5.3 liegt mit 62,2 Prozent darüber.
Damit stützt der Vergleich Mistrals Anspruch auf leistungsfähige allgemeine Agenten, aber keinen pauschalen Spitzenplatz. Für Entwickler sind erfolgreiche Tool-Aufrufe und korrekt abgeschlossene Aufgaben die relevante Prüffrage; ein aggregierter Benchmark ersetzt keinen Test mit den eigenen Berechtigungen und Dokumenten.
Sicherheit und Verfügbarkeit getrennt beurteilen
Mistral nennt außerdem 82 Prozent für einen Cyber-Test zur Reproduktion und Behebung realer Schwachstellen. Laut Anbieter erreichen einige geschlossene Vergleichsmodelle dort wegen Verweigerungen nahezu null. Das misst neben Problemlösung auch Sicherheitsrichtlinien und darf nicht als reiner Fähigkeitsabstand gelesen werden.
Die öffentliche Preview und das Red-Teaming ausgewählter Partner sind ebenfalls zu unterscheiden: Letztere erhalten laut Ankündigung reduzierte Moderation und erweiterte Cyber-Fähigkeiten. Diese Bedingungen beschreiben nicht automatisch den normalen API-Zugang.
Wer Mistral Large 4 jetzt ausprobieren will, nutzt die gehostete Preview. Wer lokale Kontrolle benötigt, muss auf die angekündigten Gewichte und deren tatsächliche Lizenz- und Runtime-Angaben warten. Die Benchmarks liefern bereits konkrete Anhaltspunkte für Coding und Agentenarbeit; den versprochenen offenen Betrieb belegen sie noch nicht.