EmbeddingGemma 2 erweitert Googles lokales Embedding-Modell von Text auf Bilder, Audio und Video. Die Ankündigung vom 6. Oktober 2026 beschreibt einen gemeinsamen Vektorraum für unterschiedliche Medien. Das Modell erzeugt damit keine Chatantworten: Es ordnet Inhalte so ein, dass Anwendungen passende Dateien, Bildmotive oder Aufnahmeabschnitte finden können.
Ein Suchmodell für mehrere Medien
Ein Embedding ist eine numerische Darstellung eines Inhalts. Ähnliche Inhalte sollen im Vektorraum nahe beieinander liegen. Bei einem multimodalen Modell kann die Suchanfrage eine andere Form haben als der Treffer: Text findet beispielsweise ein Bild, eine gesprochene Anfrage einen Videoabschnitt.
Das ist für lokale Medienarchive und Retrieval-Augmented Generation interessant. Statt zunächst jede Aufnahme ausschließlich in Text umzuwandeln, lässt sich ihre Repräsentation mit anderen Medien vergleichen. Ein generatives Modell kann anschließend die gefundenen Informationen verarbeiten. Suche und Antwortgenerierung bleiben jedoch getrennte Aufgaben; EmbeddingGemma selbst prüft nicht automatisch die Richtigkeit einer späteren Antwort.
Modular aufgebaut und offen lizenziert
EmbeddingGemma 2 basiert auf Gemma 4 und umfasst laut Google rund 740 Millionen Parameter. Für reine Textaufgaben nennt der Anbieter 270 Millionen; ein Bildencoder ergänzt 170 Millionen, ein Audioencoder 300 Millionen. Diese Modularität ist für Anwendungen relevant, die nicht alle Medienarten benötigen.
Die offizielle Modellkarte weist Apache 2.0 aus. Die Gewichte sind öffentlich und ohne Login zugänglich. Im am 12. Oktober geprüften Dateiverzeichnis ist eine Safetensors-Datei mit 1.488.915.288 Bytes vorhanden. Das entspricht dem veröffentlichten vollständigen Gewichtsartefakt, nicht dem Arbeitsspeicherbedarf jeder möglichen Betriebsart.
Google nennt quantisierte Smartphone-Konfigurationen mit ungefähr 191 MB aktivem RAM für Textgewichte beziehungsweise 567 MB für das multimodale Modell. Diese Angaben beziehen sich auf den beschriebenen Pixel-11-Pro-Versuch. Sie dürfen nicht mit den unquantisierten Hugging-Face-Dateien oder dem gesamten Speicherbedarf einer fertigen Anwendung gleichgesetzt werden.
Code-Suche verbessert sich im Herstellervergleich
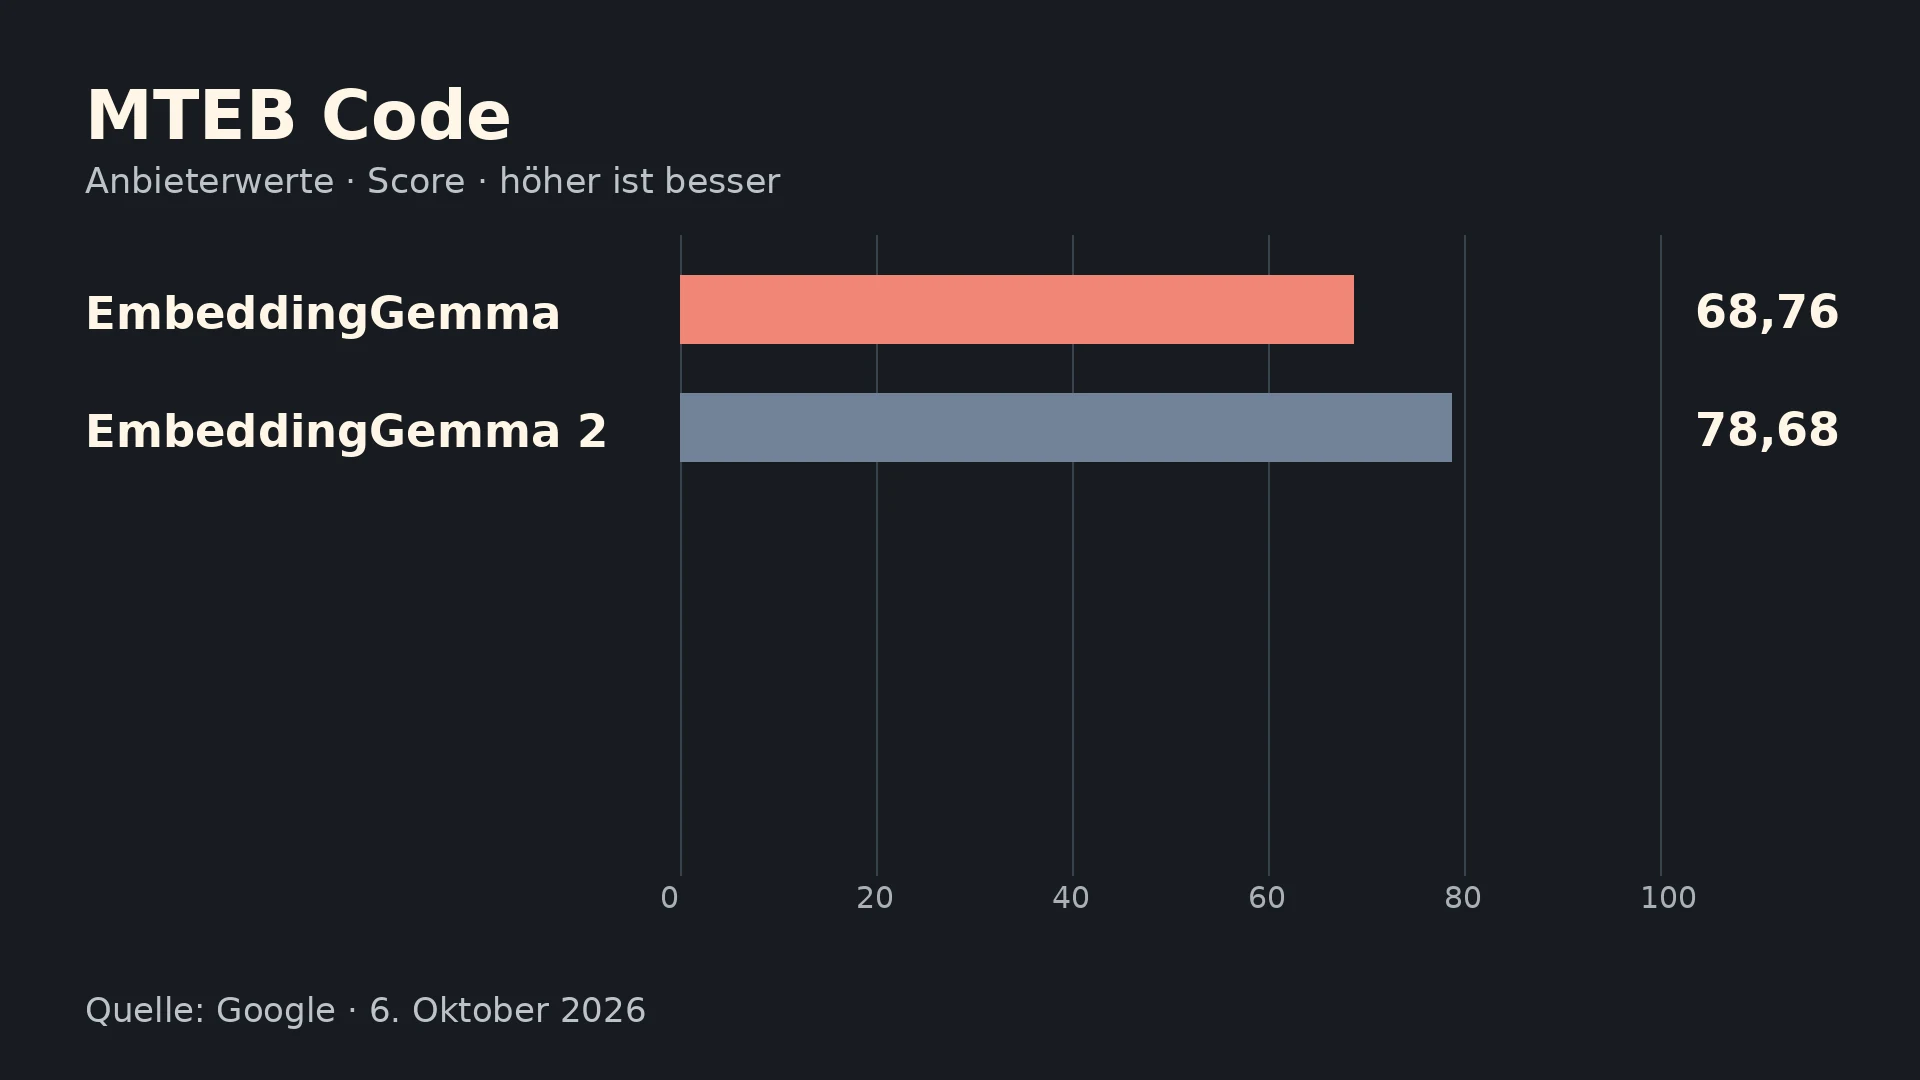
Auf MTEB Code steigt der berichtete Wert von 68,76 für EmbeddingGemma auf 78,68 für EmbeddingGemma 2. Damit veröffentlicht Google einen konkreten Fortschritt bei der Suche und Einordnung von Code, nicht nur eine zusätzliche Liste unterstützter Medien.
Die Werte stammen aus Googles Evaluation. Ob daraus bessere Treffer für ein bestimmtes deutschsprachiges Archiv oder ein eigenes Repository entstehen, hängt auch von Datenaufbereitung, Suchanfragen und der Auswahl relevanter Testtreffer ab. Ein Benchmarkwert ersetzt diese Prüfung nicht.
Das Modell unterstützt ein Kontextfenster von 8K Tokens. Google nennt als mögliche Eingaben bis zu 5,5 Minuten Audio, 29 Bilder oder 58 Videoframes sowie gemischte Sequenzen. Solche Grenzwerte sind keine Zusage, dass jede Kombination gleichzeitig in voller Länge verarbeitet werden kann.
Kleinere Vektoren, aber keine kostenlose Qualitätsgarantie
Mit Matryoshka Representation Learning lassen sich die Ausgaben von 768 Dimensionen auf 512, 256 oder 128 verkürzen. Für lokale Vektordatenbanken ist diese Wahl eine Abwägung zwischen Speicher und Trefferqualität. Die gesamte Anwendung wird dadurch nicht automatisch im selben Verhältnis kleiner: Metadaten, Originaldateien und Suchindex-Strukturen bleiben zusätzlich vorhanden.
Wie Entwickler sinnvoll beginnen
Google verlinkt die Gewichte auf Hugging Face und Kaggle sowie Integrationen für Google AI Edge, LiteRT und mehrere Entwickler-Runtimes. Die konkrete Unterstützung sollte anhand der aktuellen Anleitung des gewählten Werkzeugs geprüft werden; die Aufzählung macht nicht jede Medienkombination in jeder Oberfläche gleich verfügbar.
Für einen ersten Test eignet sich ein begrenztes Archiv mit bekannten Suchzielen. Relevant ist, ob die richtige Datei oder der richtige Abschnitt unter den ersten Treffern liegt. Erst danach lohnt sich die Entscheidung über Vektorlänge und zusätzliche Encoder. Lokal berechnete Embeddings ermöglichen einen lokalen Suchpfad; ob das gesamte Produkt offline und ohne Upload arbeitet, hängt weiterhin von seiner übrigen Architektur ab.