Claude Haiku 5.5 ist Anthropics neues kleines Sprachmodell für schnelle, häufig wiederholte Aufgaben und klar begrenzte Agentenarbeit. Die Ankündigung vom 7. Oktober 2026 positioniert es für Zusammenfassungen, Klassifikation, Datenbankabfragen, Browserbedienung und Coding-Subagenten. Haiku wird leistungsfähiger, ersetzt bei anspruchsvoller Softwareentwicklung aber nicht automatisch Sonnet oder Opus.
Benchmarks: deutlich vor Haiku 4.5, hinter Sonnet 5.5
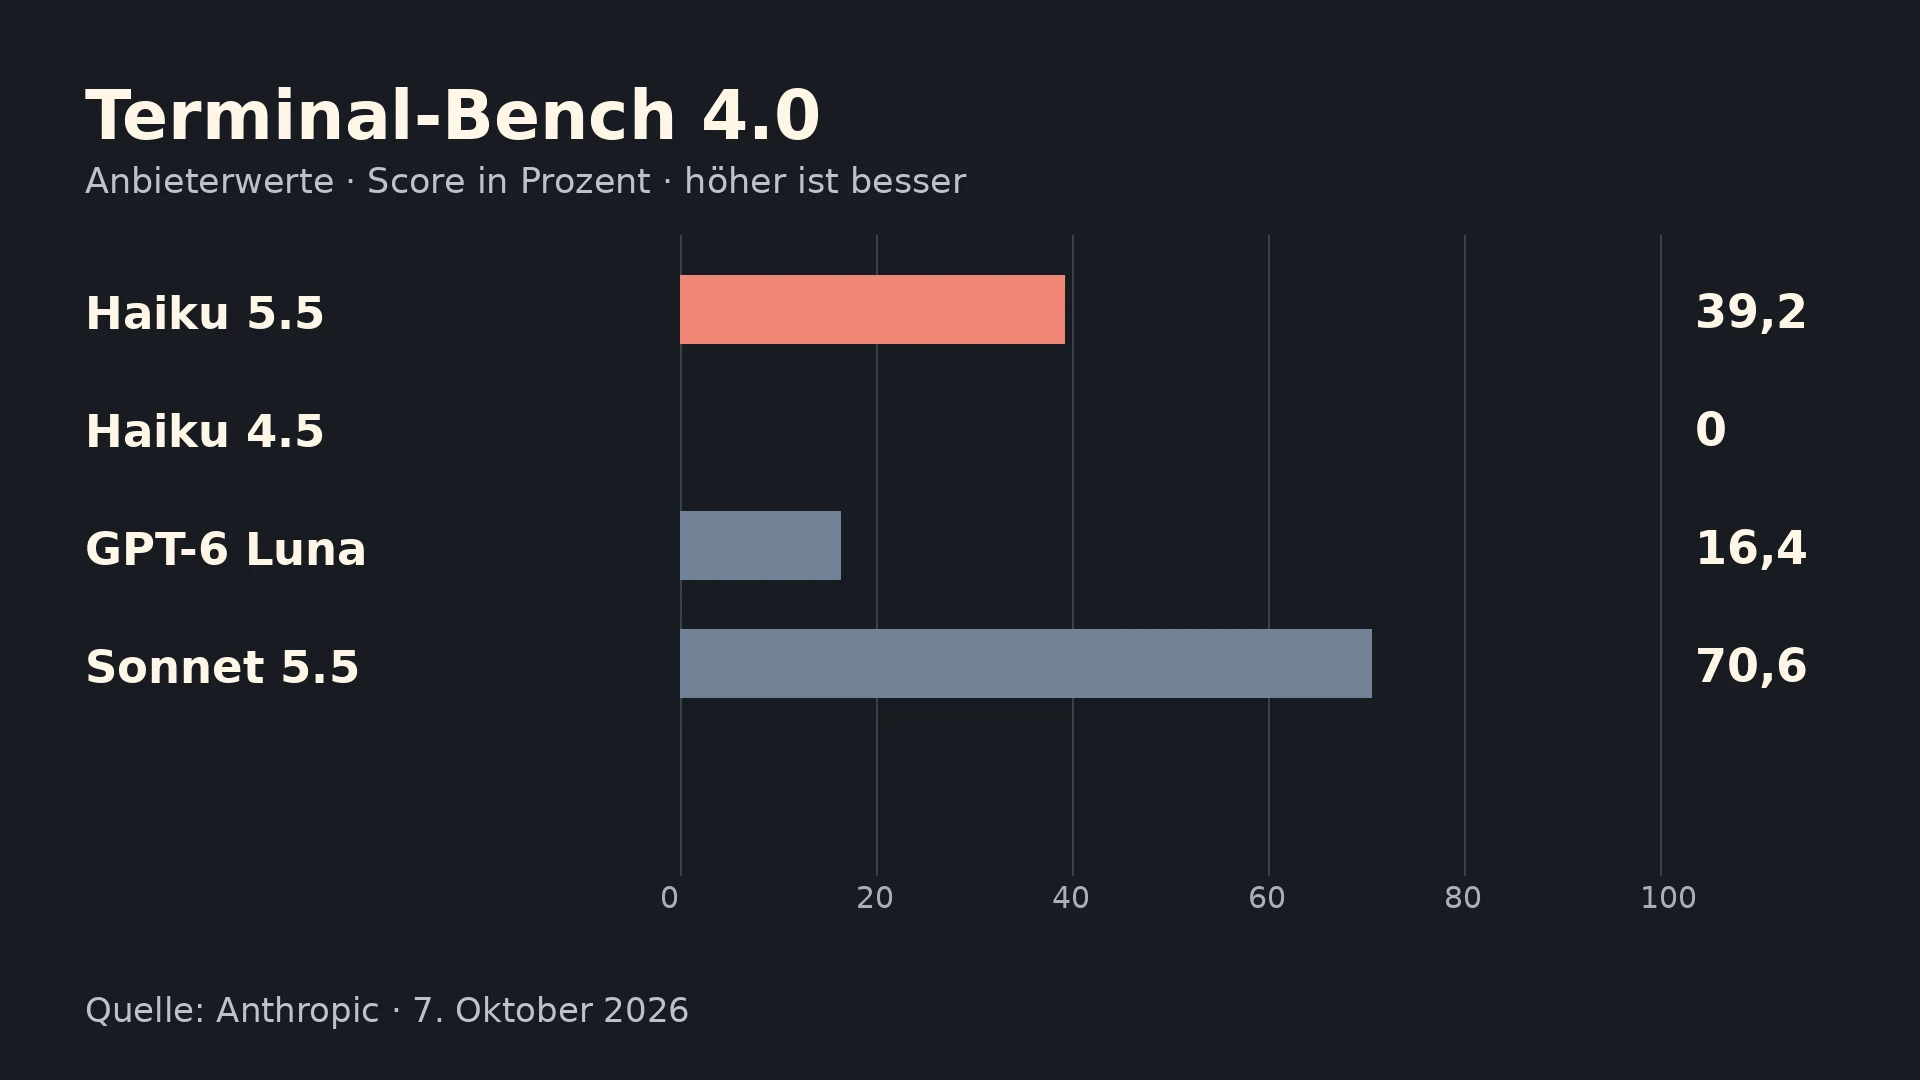
Anthropic veröffentlicht einen Vergleich mit Haiku 4.5, GPT-6 Luna und Sonnet 5.5. Auf Terminal-Bench 4.0 erreicht Haiku 5.5 einen Wert von 39,2 Prozent, gegenüber 0,0 Prozent für Haiku 4.5 und 16,4 Prozent für GPT-6 Luna. Sonnet 5.5 liegt mit 70,6 Prozent deutlich höher. Diese Aufgabe prüft mehrstufige Arbeit im Terminal; sie ist keine allgemeine Erfolgsquote für beliebige Programmieraufträge.
Auch bei Computerbedienung ist der Unterschied groß: Im Offline-Teilsatz von OSWorld 2.1 berichtet Anthropic 72,4 Prozent für Haiku 5.5, 15,7 für Haiku 4.5 und 48,9 für GPT-6 Luna. Sonnet erzielt 83,9 Prozent. Der Offline-Zusatz ist wichtig: Aus dieser Auswertung lässt sich keine identische Leistung beim Zugriff auf beliebige Live-Webseiten ableiten.
Bei Humanity’s Last Exam erreicht das neue Modell ohne Werkzeuge 45,9 Prozent und mit Werkzeugen 57,4 Prozent. Das sind zwei unterschiedliche Evaluationsbedingungen, keine austauschbaren Kennzahlen. Sämtliche Werte stammen aus Anthropics Veröffentlichung, nicht aus einem eigenen KTU-Test.
Aufwand einstellen statt immer maximal rechnen
Erstmals unterstützt die Haiku-Klasse ein veränderbares Effort-Setting. Entwickler können damit den Rechenaufwand stärker an die Schwierigkeit einer Teilaufgabe anpassen. Eine kurze Klassifikation muss nicht dieselbe Verarbeitungstiefe bekommen wie eine mehrstufige Recherche.
Für einen Agentenworkflow ergibt sich daraus ein konkretes Muster: Das größere Modell plant und kontrolliert; Haiku erledigt eng beschriebene Teilaufträge. Ein Coding-Agent könnte beispielsweise einzelne Dateien durchsuchen, Fehlermeldungen zusammenfassen oder vorhandene Testfälle kategorisieren lassen. Die abschließende Entscheidung über eine Codeänderung bleibt eine andere, anspruchsvollere Aufgabe.
Sinnvoll ist dieser Einsatz nur, wenn Fehler erkennbar bleiben. Wer einem schnellen Subagenten eine offene Aufgabenstellung mit weitreichenden Schreibrechten übergibt, hat nicht allein durch den günstigeren Modellpreis einen besseren Prozess gebaut.
Niedrigere Preise hängen auch von der Promptlänge ab
Anthropic nennt für Prompts bis 100.000 Tokens 0,10 US-Dollar pro Million Eingabetokens und 0,50 US-Dollar pro Million Ausgabetokens. Bei längeren Prompts steigen diese Preise auf 0,50 beziehungsweise 2,50 US-Dollar. Die höhere Stufe muss deshalb in die Kostenplanung großer Dokumenten- oder Codekontexte einfließen.
Der Anbieter beschreibt durchschnittlich rund 75 Prozent niedrigere Betriebskosten als bei Haiku 4.5. Das ist nicht dasselbe wie eine garantierte Ersparnis für jede Anwendung: Promptlänge, Ausgabelänge, Cache-Nutzung und der veränderte Tokenizer beeinflussen die Rechnung.
Zugang und sinnvolle Migration
Haiku 5.5 ist laut Anthropic auf der Claude Platform sowie über AWS, Google Cloud und Microsoft Azure verfügbar. Die Modellkennung lautet claude-haiku-5-5. Es handelt sich um ein gehostetes Modell, nicht um einen Download offener Gewichte.
Vor einer Umstellung sollten Entwickler die Migrationshinweise und eigene repräsentative Aufgaben prüfen. Relevant sind korrekt abgeschlossene Teilaufträge, benötigte Nacharbeit und tatsächliche Gesamtkosten. Der veröffentlichte Abstand zu Sonnet auf Terminal-Bench spricht ausdrücklich gegen einen pauschalen Austausch des Hauptmodells. Haikus stärkster Einsatz bleibt die eng begrenzte, häufige Arbeit innerhalb eines kontrollierten Workflows.