Amazon veröffentlicht mit ALoDLM eine Familie adaptiv geloopter Diffusions-Sprachmodelle für Text und Code. Die Varianten ALoDLM-1.7B und ALoDLM-8B basieren auf den entsprechenden Qwen3-Modellen. Anders als bei einer bloßen Forschungsankündigung stehen Gewichte und Inferenzcode öffentlich bereit. Die Modellkarte von ALoDLM-8B nennt allerdings CC BY-NC 4.0: Der Release ist auf nichtkommerzielle Nutzung ausgerichtet, nicht auf uneingeschränkten Produkteinsatz.
Schwierige Tokens erhalten mehr Rechenarbeit
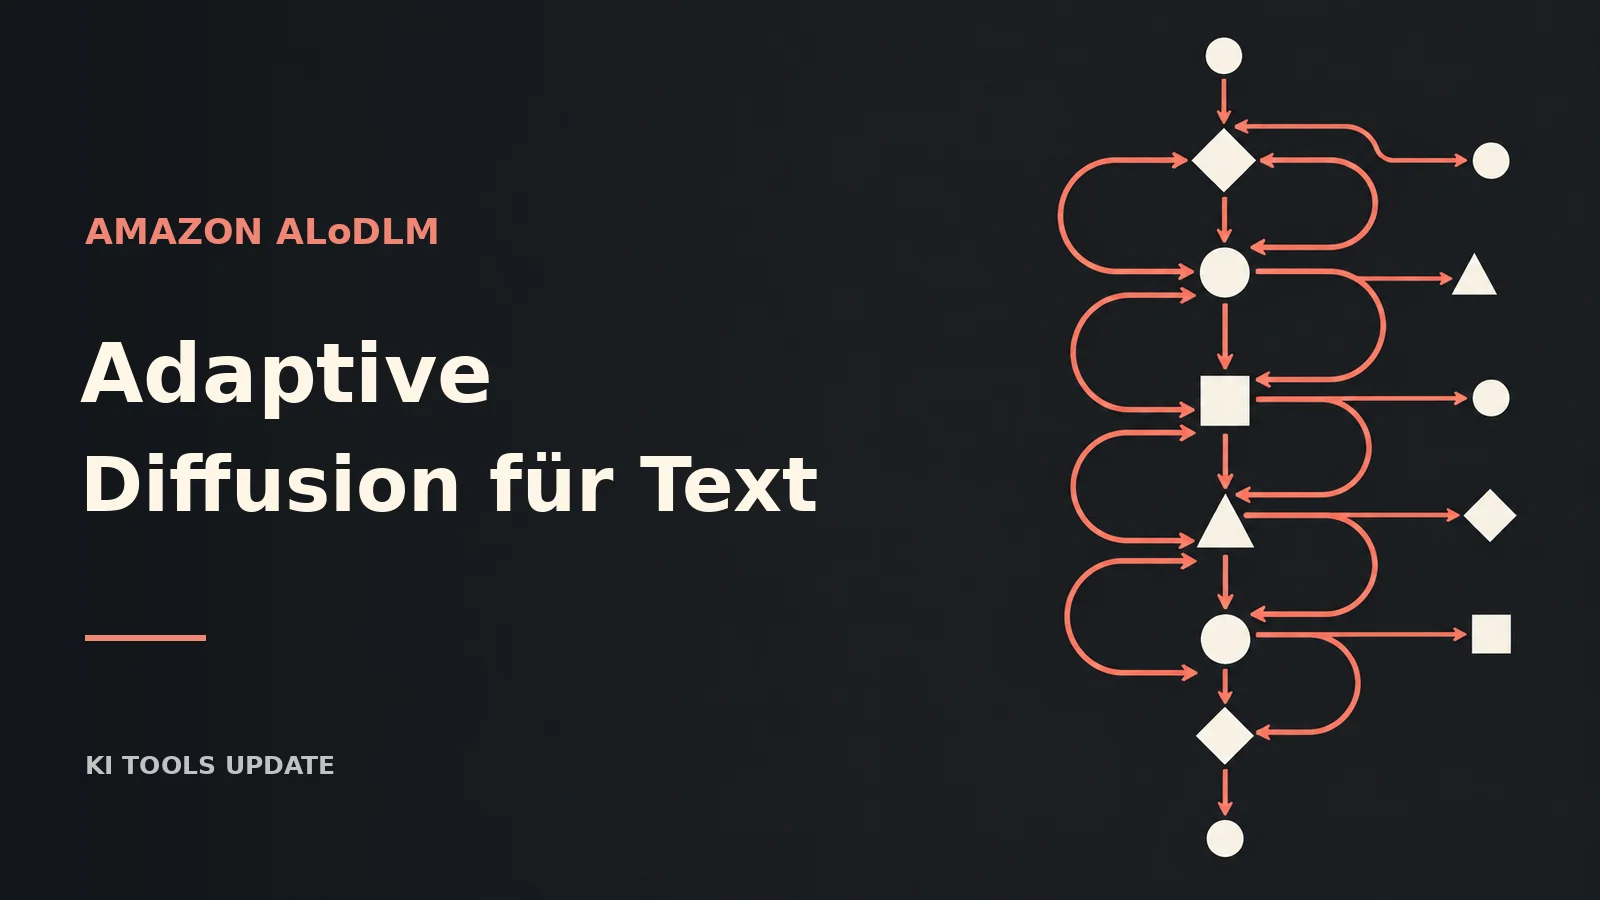
Ein autoregressives Modell erzeugt Text normalerweise Token für Token. Maskierte Diffusionsmodelle bearbeiten mehrere noch unbekannte Positionen gemeinsam. ALoDLM erweitert dieses Prinzip um wiederholte Durchläufe durch gemeinsam genutzte Transformer-Schichten.
Bereits festgelegte Tokens liefern dabei diskreten Kontext. Noch ungelöste Positionen behalten ihre latenten Zustände und werden weiter verfeinert. Eine gelernte Halteentscheidung steuert, wann die Schleife endet; Vorhersagesicherheit steuert, welche Tokens festgelegt werden. Der Ansatz verteilt Rechenarbeit adaptiv, statt allen Positionen dieselbe Verarbeitungstiefe aufzuzwingen.
Die offizielle Code-Dokumentation beschreibt separate portable und optimierte Inferenzpfade. Ein gewöhnlicher Transformers-Aufruf des Qwen3-Backbones bildet die Methode nicht vollständig ab: Wiederholungslogik, Rekurrenzkonfiguration und gelerntes Exit-Gate gehören zum freigegebenen Modell.
Benchmarks: besserer Durchschnitt, nicht jeder Einzeltest
Amazons Qualitätsvergleich umfasst elf Aufgaben aus Wissen, Mathematik und Programmierung. Der ungewichtete Durchschnitt beträgt für ALoDLM-8B 80,3 Prozent. Qwen3-8B erreicht 78,5, WeDLM-8B 75,1 und SDAR-8B 74,2 Prozent.
Einzelwerte zeigen sowohl Stärken als auch Grenzen:
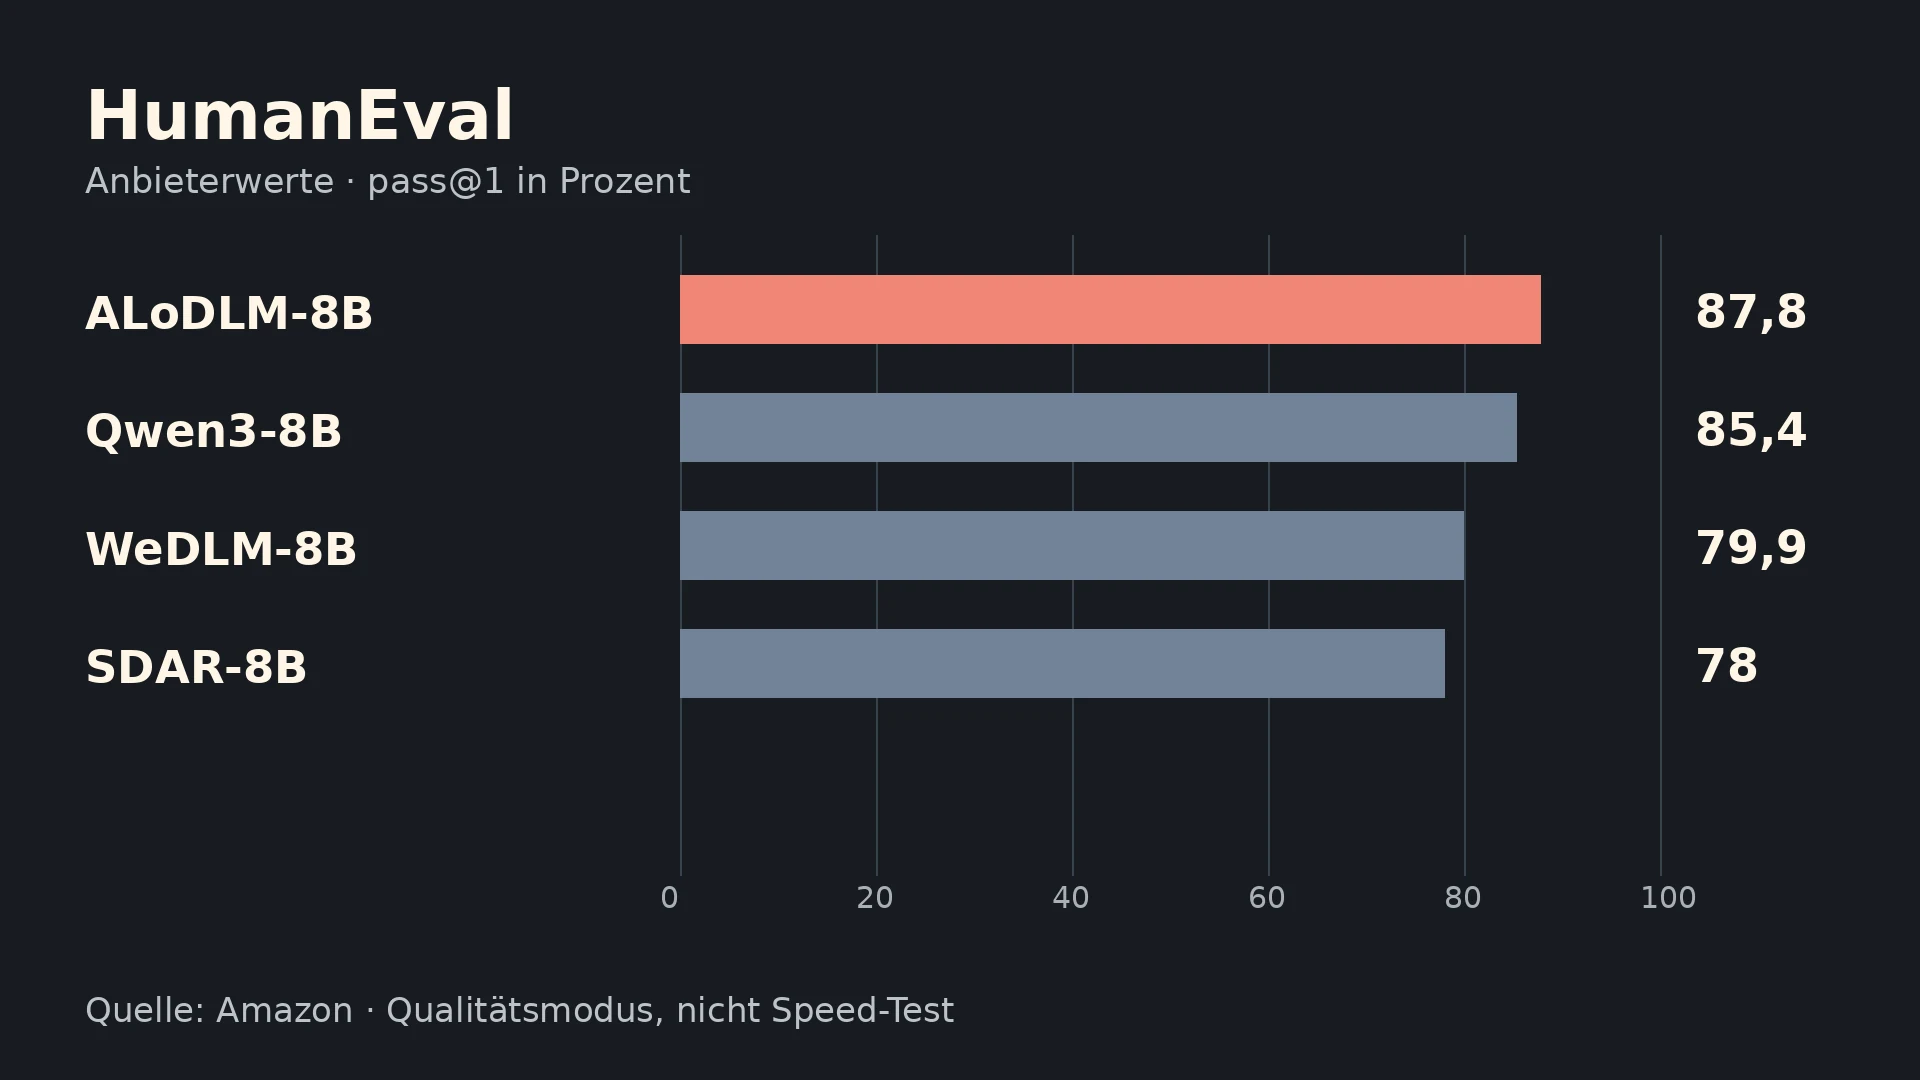
- HumanEval: ALoDLM-8B erreicht 87,8 Prozent, Qwen3-8B 85,4 und WeDLM-8B 79,9. Hier handelt es sich um ausführungsbasiertes pass@1.
- GPQA-Diamond: ALoDLM-8B erzielt 49,5 Prozent gegenüber 47,0 für Qwen3-8B und 37,4 für WeDLM-8B.
- MATH-500: Qwen3-8B liegt mit 81,8 Prozent vor ALoDLM-8B mit 80,8. Der bessere Durchschnitt bedeutet also keinen Sieg in jeder Disziplin.
Bei der kleineren Variante kommt ALoDLM-1.7B auf durchschnittlich 65,5 Prozent, gegenüber 63,8 für Qwen3-1.7B und 61,0 für SDAR-1.7B. Alle genannten Ergebnisse sind die veröffentlichten Forschungswerte des Anbieters, kein eigener Praxistest.
Die Auswertung folgt dem OpenCompass-Protokoll von SDAR, verwendet native Chat-Templates, greedy Tokenauswahl und maximal 4096 Ausgabetokens. ALoDLM arbeitet mit einem 16-Token-Fenster und Halteschwellen von 0,4 beziehungsweise 0,5. Pro rekurrentem Durchlauf wird ein Token festgelegt; entropiebasierte parallele Festlegung ist in dieser Qualitätstabelle deaktiviert.
Der Geschwindigkeitsvergleich nutzt einen anderen Modus
Die README berichtet auf GSM8K ungefähr den 2,7-fachen Durchsatz gegenüber Qwen3-8B mit vLLM bei vergleichbarer oder höherer Genauigkeit. Das Experiment läuft als einzelner Ausgabestrom auf einer NVIDIA B200, mit optimierten Engines und paralleler Tokenfestlegung.
Diese Betriebsart unterscheidet sich ausdrücklich von der Qualitätstabelle. Man darf die dortigen 80,3 Prozent deshalb nicht als gleichzeitig gemessene Qualität des schnelleren Decoders ausgeben. Auch die Geschwindigkeit des portablen PyTorch-Pfads ist damit nicht belegt. Rekurrente Verarbeitung kann die Zeit bis zum ersten Token verlängern; kurze Antworten und schwierige Eingaben können weniger vom parallelen Decoding profitieren.
Downloads, Hardware und Lizenzgrenzen
Die am 12. Oktober 2026 geprüften Hugging-Face-Dateien sind ohne Login erreichbar. ALoDLM-8B umfasst vier BF16-Safetensors-Shards mit zusammen 16.381.516.824 Bytes. Bei ALoDLM-1.7B enthält eine Safetensors-Datei 4.063.515.640 Bytes. Exit-Gate, Tokenizer und Konfiguration kommen hinzu; Dateigröße ist nicht gleich erforderlicher Laufzeitspeicher.
Der optimierte 8B-Pfad wurde laut Modellkarte auf einer A100 mit 40 GB geprüft. Das ist eine getestete Konfiguration, keine allgemeine Mindestanforderung. Speicherbedarf hängt auch von Kontext, Cache und Laufzeit ab.
Die Gewichte verlangen Namensnennung und nichtkommerzielle Nutzung; Hinweise der Apache-2.0-lizenzierten Qwen3-Basismodelle bleiben zusätzlich relevant. Für den optimierten Code nennt Amazon weitere Drittanbieterbedingungen. ALoDLM eignet sich damit vor allem für reproduzierbare Forschung an adaptiver Inferenz, nicht als pauschal frei lizenzierter Ersatz für produktive Chat-Modelle.