Iris-3B von SperidLabs erzeugt Bilder direkt im Pixelraum, ohne zwischengeschalteten VAE. Das Modell ist nicht nur eine Forschungsankündigung: Code und Gewichte für Text-zu-Bild, Tiefenschätzung sowie Bildrestaurierung mit vierfacher Vergrößerung sind öffentlich verfügbar. Der Bericht vom 7. Oktober 2026 liefert allerdings eine wichtige Einschränkung gleich mit: Pixelraum-Modelle waren bei den untersuchten Folgeaufgaben nicht grundsätzlich besser als die verglichenen latenten Modelle.
Was „ohne VAE“ bei Iris-3B bedeutet
Viele Diffusionsmodelle generieren zunächst eine komprimierte Bildrepräsentation, die ein separater Decoder wieder in Pixel übersetzt. Iris-3B verzichtet auf diesen Weg. Sein Transformer verarbeitet Bildpatches; ein kleiner Pixel-Transformer-Kopf erzeugt daraus die RGB-Pixel. Die Projektseite beschreibt einen Backbone mit drei Milliarden Parametern und 16 × 16 Pixel großen Patches.
Die 3B-Angabe umfasst nicht den Textencoder. Für Text-zu-Bild kommt zusätzlich der eingefrorene Qwen3-VL-4B-Instruct zum Einsatz. Laut Modellkarte wird er beim ersten Start separat heruntergeladen. Die Standardausgabe beträgt 1024 × 1024 Pixel; Beispiele nutzen auch andere Seitenverhältnisse bei ungefähr einem Megapixel.
Der Architekturunterschied ist relevant für Forschung und Fine-Tuning: Die Modellfamilie erlaubt, denselben pixelbasierten Backbone für mehrere Aufgaben anzupassen. Daraus folgt aber weder automatisch geringerer Speicherbedarf noch höhere Bildqualität.
Bild-Benchmarks: konkurrenzfähig, nicht überall führend
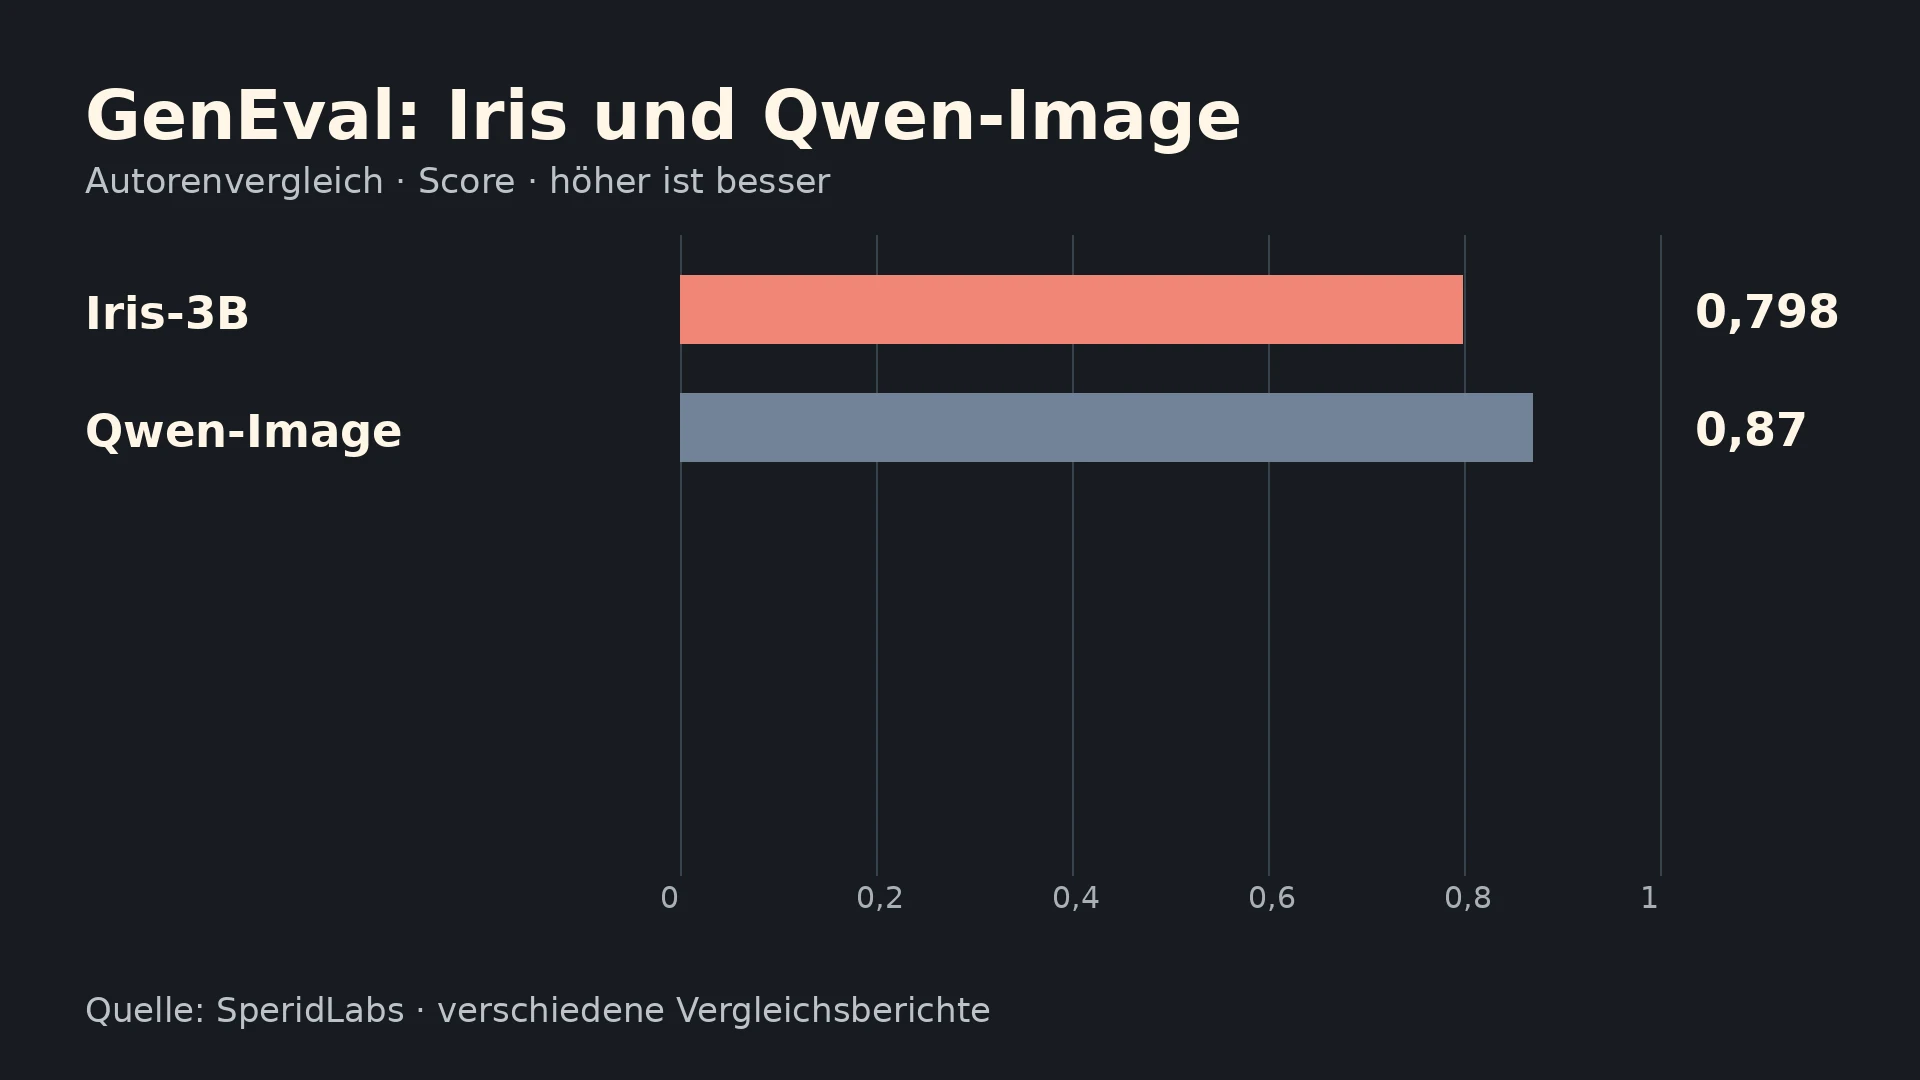
SperidLabs nennt auf der offiziellen Benchmarkseite für Iris-3B 0,798 bei GenEval, 86,52 bei DPG und 0,540 bei OneIG. Qwen-Image erreicht in derselben Übersicht 0,87, 88,3 und 0,539. Iris liegt damit bei OneIG auf einem ähnlichen Niveau, bei den beiden anderen genannten Aufgaben jedoch darunter. Ein einzelner fast gleicher Wert ist kein Beleg für eine allgemeine Überlegenheit.
Die Iris-Ergebnisse wurden laut Projektseite mit den offiziellen Evaluatoren bei 1024 × 1024 Pixeln ermittelt, ohne Prompt-Umschreibung und ohne Auswahl aus mehreren Kandidaten. Vergleichswerte stammen aus den Qwen-Image- und Z-Image-Berichten; Z-Image verwendet laut Fußnote Prompt-Umschreibung. Die Übersicht ist deshalb als Autorenvergleich mit dokumentierten Unterschieden zu lesen, nicht als eigener KTU-Test.
Tiefenschätzung und Upscaling: drei getrennte Checkpoints
Zusätzlich zum Bildgenerator veröffentlicht SperidLabs zwei aufgabenspezifisch angepasste Varianten im offiziellen Gewichtsrepository:
- Depth schätzt aus einem einzelnen Foto relative logarithmische Tiefe.
- Upscaler restauriert ein Eingangsbild und vergrößert es um den Faktor vier.
Diese Funktionen sind keine wechselbaren Modi eines einzigen unveränderten Checkpoints. Für jede Aufgabe werden eigene Gewichte geladen. Laut Inferenzdokumentation benötigen die beiden Varianten nur einen Vorwärtsdurchlauf und keinen Textencoder. Große Restaurierungsausgaben werden in überlappende Kacheln aufgeteilt.
Bei Tiefe ist die Einschränkung entscheidend: relative Tiefe ist keine metrische Entfernungsmessung. Das Ergebnis eignet sich als Grundlage für Tiefenmasken oder Experimente mit räumlicher Bildwirkung, liefert aber nicht ohne zusätzliche Kalibrierung verlässliche Meterangaben.
Auch die zentrale Forschungsthese hält dem Vergleich nicht vollständig stand. Im Paper erreicht Iris bei Tiefenschätzung das Niveau eines latenten FLUX.2-Klein-Modells. Bei der vierfachen DIV2K-Restaurierung übertrifft keines der untersuchten Pixelraum-Modelle den entsprechend angepassten latenten FLUX.2-Klein-Vergleich. Die Autoren berichten keine signifikante Verbesserung durch den Pixelraum-Prior. Der Verzicht auf VAE-Kompression ist also ein Architekturmerkmal, kein bewiesenes Qualitätsversprechen für diese Aufgaben.
Download, Lizenz und Hardwarebedarf
Code, Training und Inferenz sowie die offiziellen Gewichte stehen unter Apache 2.0; Drittanbieterkomponenten behalten ihre eigenen Lizenzen. Die drei Hauptgewichtsdateien im Hugging-Face-Repository messen jeweils rund zwölf GB. Wer nur Bilder generieren möchte, benötigt nicht zusätzlich die Depth- und Upscaler-Gewichte.
Die Downloadgröße darf nicht mit dem VRAM-Bedarf verwechselt werden. Die Demo-Dokumentation nennt für alle drei gleichzeitig geladenen Modelle ungefähr 45 GB GPU-Speicher. Bei aktiviertem CPU-Offloading nennt sie ungefähr 20 GB Spitzenauslastung, weil pro Anfrage nur das benötigte Modell auf die GPU wandert. Das sind dokumentierte Entwicklerangaben, keine eigenen Messungen und keine universelle Mindestanforderung für jede Einzelkonfiguration.
Wie ein sinnvoller Einstieg aussieht
Die verlinkte Hugging-Face-Demo bietet einen Einstieg ohne lokalen Modelldownload. Für eigene Experimente sollte zuerst eine Aufgabe ausgewählt werden: Bildgenerierung, relative Tiefe oder Restaurierung. So bleiben Download und Speicherplanung überschaubar.
Für Restaurierung ist ein Vergleich am selben Ausgangsbild sinnvoll: nicht nur Schärfe prüfen, sondern auch veränderte Strukturen und Farben. Bei Tiefenkarten zählt die plausible räumliche Ordnung, nicht eine vermeintliche Entfernung in Metern. Iris-3B ist damit ein konkret nutzbares, offen dokumentiertes Forschungsmodell – besonders wertvoll für Entwickler, die Pixelraum-Ansätze selbst untersuchen möchten, statt aus dem Begriff „ohne VAE“ pauschale Überlegenheit abzuleiten.