Ricursive Intelligence hat am 4. November 2026 Ripple-65B Preview veröffentlicht: ein dichtes Sprachmodell mit 65 Milliarden Parametern, vortrainiert auf 12 Billionen Tokens, mit Kontextfenster bis eine Million Tokens. Die Gewichte stehen unter Apache 2.0 auf Hugging Face.
Primärquellen sind der Launch-Beitrag https://www.ricursive.com/ripple und die Modellkarte https://huggingface.co/ricursiveAI/Ripple-65B-Preview (Stand 04.11.2026). Alle Werte stammen aus der Modellkarte. Das Unternehmen schreibt selbst, die Nachprüfung von Benchmarkwerten sei schwierig und die Tabelle sei ein Bemühen um faire Vergleiche mit teils unterschiedlichen Testumgebungen.
Die Zahlen
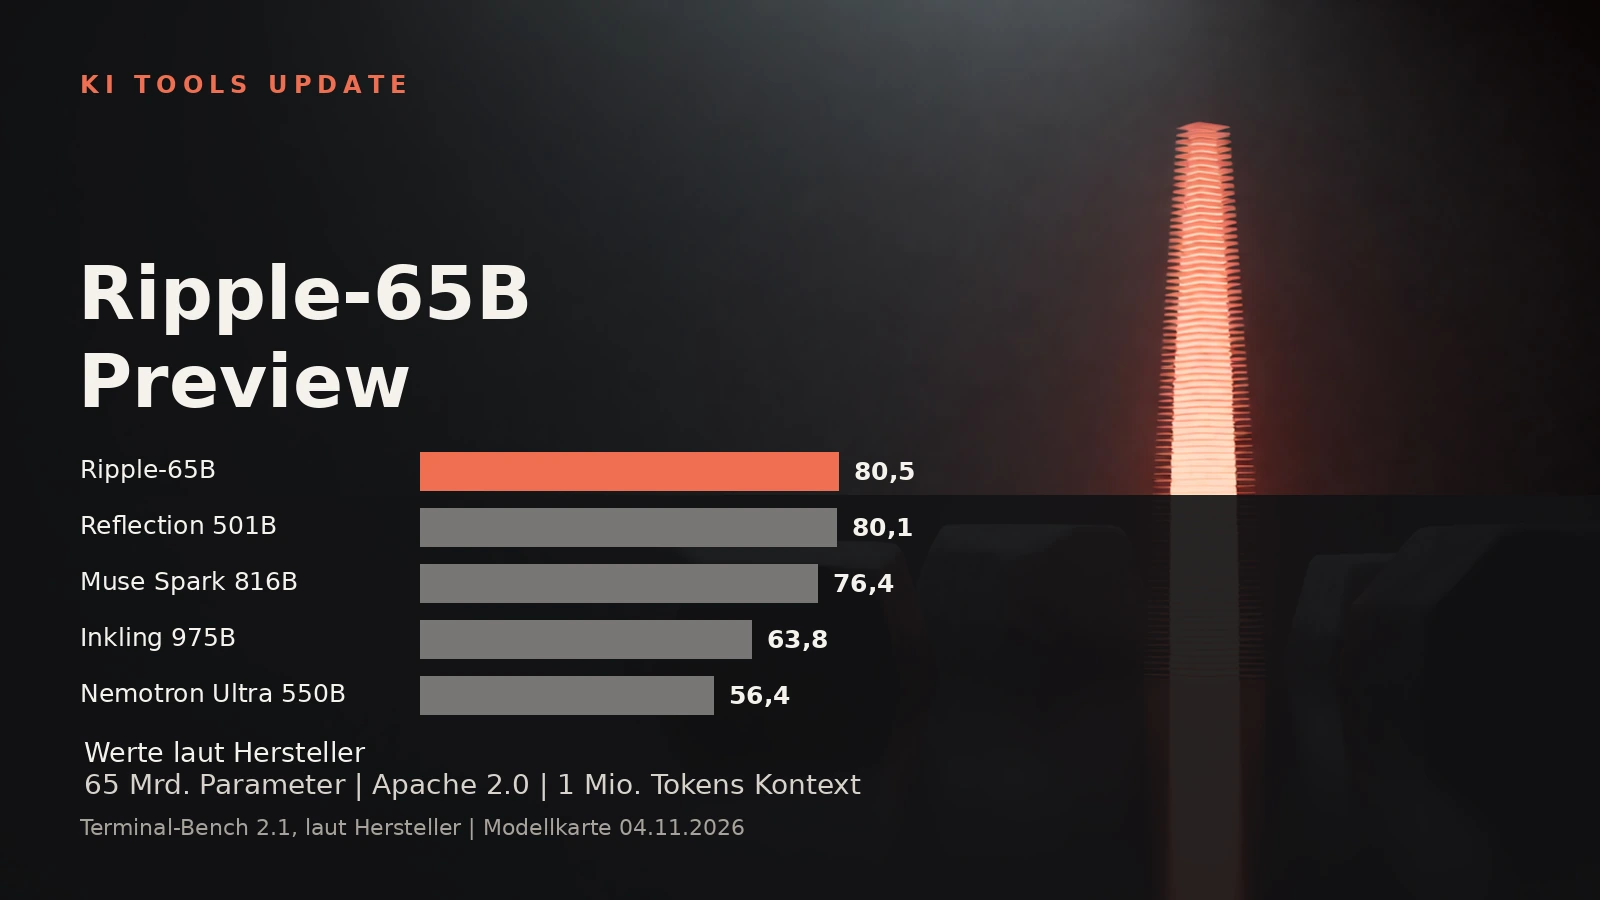
Terminal-Bench 2.1, agentisches Codieren, Herstellerangaben:
- Ripple-65B Preview: 80,5
- Reflection Beam 501B: 80,1
- Meta Muse Spark Open 816B: 76,4 – im einheitlichen Terminus-2-Aufbau 78,7
- Thinking Machines Inkling 975B: 63,8 – im selben Aufbau 56,2
- NVIDIA Nemotron 3 Ultra 550B: 56,4 – im selben Aufbau 55,1
Weitere Werte aus derselben Tabelle:
- SWE-bench Pro v2.0 Hard: 79,1 gegenüber 76,5 bei Reflection Beam, 72,4 bei Muse Spark Open, 39,6 bei Inkling und 30,7 bei Nemotron
- SWE-bench Verified: 76,5 – hier liegt Reflection Beam mit 81,6 vorn
- DeepSWE 1.1: 44,3 – Muse Spark Open erreicht 60,0
- τ³-bench banking: 31,27 gegenüber 36,1 bei Reflection Beam
- GPQA Diamond: 85,2 gegenüber 90,6 bei Reflection Beam und 89,0 bei Muse Spark Open
Wie es gebaut ist
Ripple ist ein dichter Transformer statt eines Mixture-of-Experts-Modells. Die Form ist schmal und tief: 5120 Dimensionen im Modellkanal, 80 Schichten, eine an Gemma 3N angelehnte Architektur mit gated Attention, global NoPE, Value Residuals und FFN-Activation-Clipping. Die Auslastung der Recheneinheiten lag laut Unternehmen bei 40 Prozent, ohne eigene Kernel und ohne Quantisierung.
Gebaut haben das Modell nach eigenen Angaben ein Team, das während der Entwicklung von einer auf fünf Personen wuchs. Die gesamten Forschungs- und Entwicklungskosten beziffert Ricursive mit 32 Millionen Dollar – ein Zehntel des bisherigen offenen Stands der Technik beim agentischen Codieren, so die eigene Schätzung. Beim Training folgte auf 12 Billionen Vortrainings-Tokens eine Kette aus Midtraining, Long-Context-Phase, SFT und 700 Schritten bestärkendes Lernen. Die Recheneffizienz auf Code-Perplexität liegt laut Karte 16-fach über der Olmo-3-Leiter, im finalen Trainingslauf bis 55-fach.
Zugang
Verfügbar sind ein instruktionsgetuntes BF16-Modell, ein BF16-Basismodell ohne Nachbearbeitung, eine NVFP4-Variante und ein Checkpoint für spekulative Dekodierung. Verteilung über Hugging Face, Together AI, GMI Cloud, OpenRouter und Fireworks. Auf zwei B200 erreicht das Modell 250 Tokens pro Sekunde bei Batch 8, ohne Quantisierung. Laut Modellkarte passt es auf eine NVIDIA DGX Spark.
Grenzen
- Herstellerdaten. Die Werte sind selbst berichtet, teils mit eigenem Testaufbau statt der offiziellen Umgebung. Eine unabhängige Nachprüfung fehlt.
- Ripple verliert gegen einzelne Peers: bei SWE-bench Verified, DeepSWE 1.1, τ³-bench und GPQA Diamond.
- Preview-Status. Das Nachtraining ist bewusst leicht und auf agentisches Codieren fokussiert; andere Fähigkeiten sind entsprechend weniger ausgebaut.
- Der Effizienzvergleich bezieht sich auf Code-Perplexität im Trainingsverlauf, nicht auf Nutzen im Betrieb.