NVIDIA hat am 28. Oktober 2026 Nemotron 3.5 Transcribe veröffentlicht. Es ist ein offenes Modell, das aufgezeichnete Sprache in 40 Sprachen in Text umwandelt, Sprecher unterscheidet und zusätzlich übersetzen sowie einfache Fragen zu Audioaufnahmen beantworten kann. Die Gewichte stehen auf Hugging Face und ModelScope bereit. Die Lizenz ist OpenMDW-1.1, laut Model Card ausdrücklich für kommerzielle und nicht-kommerzielle Nutzung.
Primärquelle ist der NVIDIA-Beitrag auf Hugging Face: https://huggingface.co/blog/nvidia/nemotron-transcribe-granary (Stand 28.10.2026). Alle Leistungswerte in diesem Artikel stammen vom Hersteller. Eine unabhängige Nachprüfung liegt nicht vor.
Was das Modell kann
Nemotron 3.5 Transcribe verarbeitet Aufnahmen bis zu einer Stunde Länge und kann bis zu acht Sprecher kennzeichnen. Laut NVIDIA transkribiert es 40 Sprachen, übersetzt 31 davon von und nach Englisch und ordnet Sprecher in 13 Sprachen zu. Über natürlichsprachige Anweisungen lässt sich das Ausgabeformat steuern, zum Beispiel mit Sprecherlabels oder korrekt geschriebenen Fachbegriffen. Wortgenaue Zeitstempel werden ebenfalls unterstützt.
Wichtig für die Einordnung: Das Modell ist offline. Es verarbeitet fertige Aufnahmen und ist kein Echtzeit-Streamingdienst. Die Model Card sagt das ausdrücklich.
Die Zahlen laut Hersteller
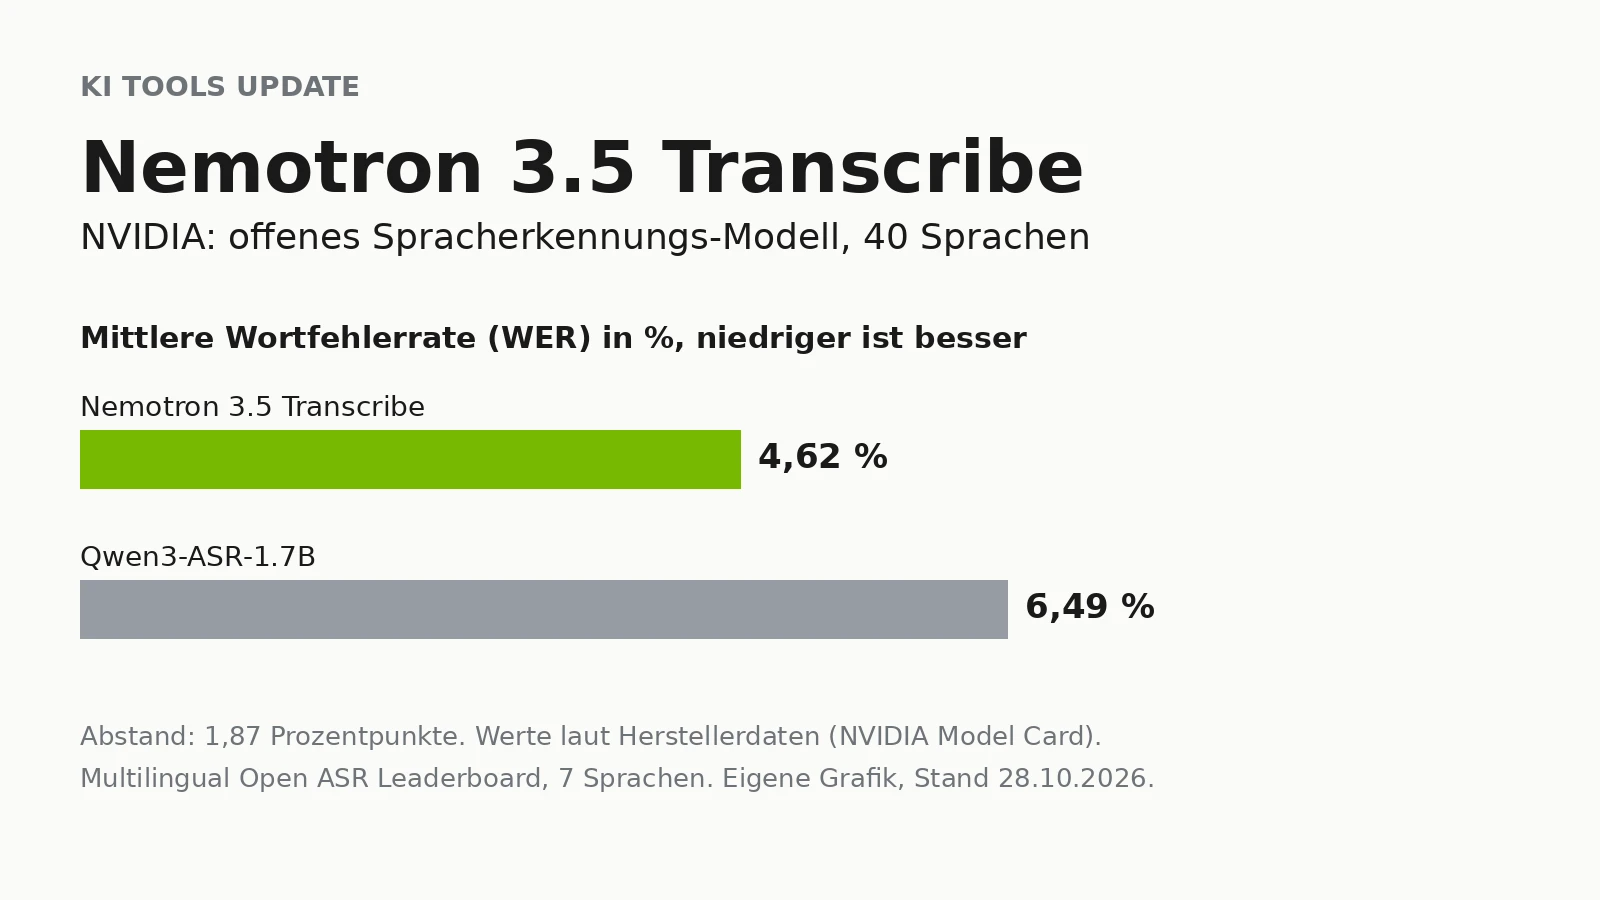
Die Wortfehlerrate (WER) misst Transkriptionsfehler. Niedriger ist besser. Die folgenden Werte stammen aus der NVIDIA Model Card:
• Mehrsprachig, 7 Sprachen (Multilingual Open ASR Leaderboard): Nemotron 3.5 Transcribe 4,62 %, Qwen3-ASR-1.7B 6,49 %.
• Langaufnahmen (Open ASR Leaderboard, long-form): Nemotron 3.5 Transcribe 10,98 %, Parakeet-TDT-0.6B-v3 13,37 %.
• Sprecherzuordnung in vollen Sitzungen (cpWER, Datensätze AMI, CALLHOME, Mixer 6, NOTSOFAR-1): Nemotron 3.5 Transcribe 15,80 %, DiCoW v3.3 + DiariZen 16,83 %.
• Englisch (9 öffentliche Datensätze): Nemotron 3.5 Transcribe 4,71 %, Qwen3-ASR-1.7B 4,94 %.
Eine Abweichung ist im Material nicht erklärt: Der Blog nennt für Englisch 5,33 % im Open ASR Leaderboard, die Model Card 4,71 % über neun Datensätze. Dieser Artikel verwendet nur die Model-Card-Werte.
Wo die Grenzen liegen
- Die Sprachunterstützung hängt von der Aufgabe ab. Laut Blog ist die Audio-Fragenbeantwortung auf Englisch trainiert. Die Sprachmatrix je Aufgabe steht in der Model Card.
- NVIDIA empfiehlt, Namen, Sprecherwechsel und Antworten gegen die Aufnahme zu prüfen.
- Die Benchmarks laufen auf öffentlichen Testsets. Sie zeigen nicht, wie das Modell mit Ihren Aufnahmen, Akzenten oder Fachbegriffen abschneidet.
Granary v2 und Feintuning
Zusammen mit dem Modell veröffentlicht NVIDIA Granary v2: mehrsprachige Trainingsdaten, eine offene Kurationspipeline und NeMo-Speech-Werkzeuge für Feintuning. In einer Medizin-Fallstudie senkte Feintuning laut NVIDIA die WER bei unbekannten Sprechern um 45,8 % relativ gegenüber der besten Prompt-Variante. Auch diese Zahl ist eine Herstellerangabe.
Einordnung für Unternehmen
Offene Gewichte bedeuten: Das Modell lässt sich grundsätzlich selbst betreiben, statt Audio an einen externen Dienst zu schicken. Ob es für Besprechungsprotokolle, Diktate oder Kundengespräche taugt, zeigt aber nur ein Test mit eigenen Aufnahmen. Vor einem kommerziellen Einsatz den Lizenztext im Original prüfen.